
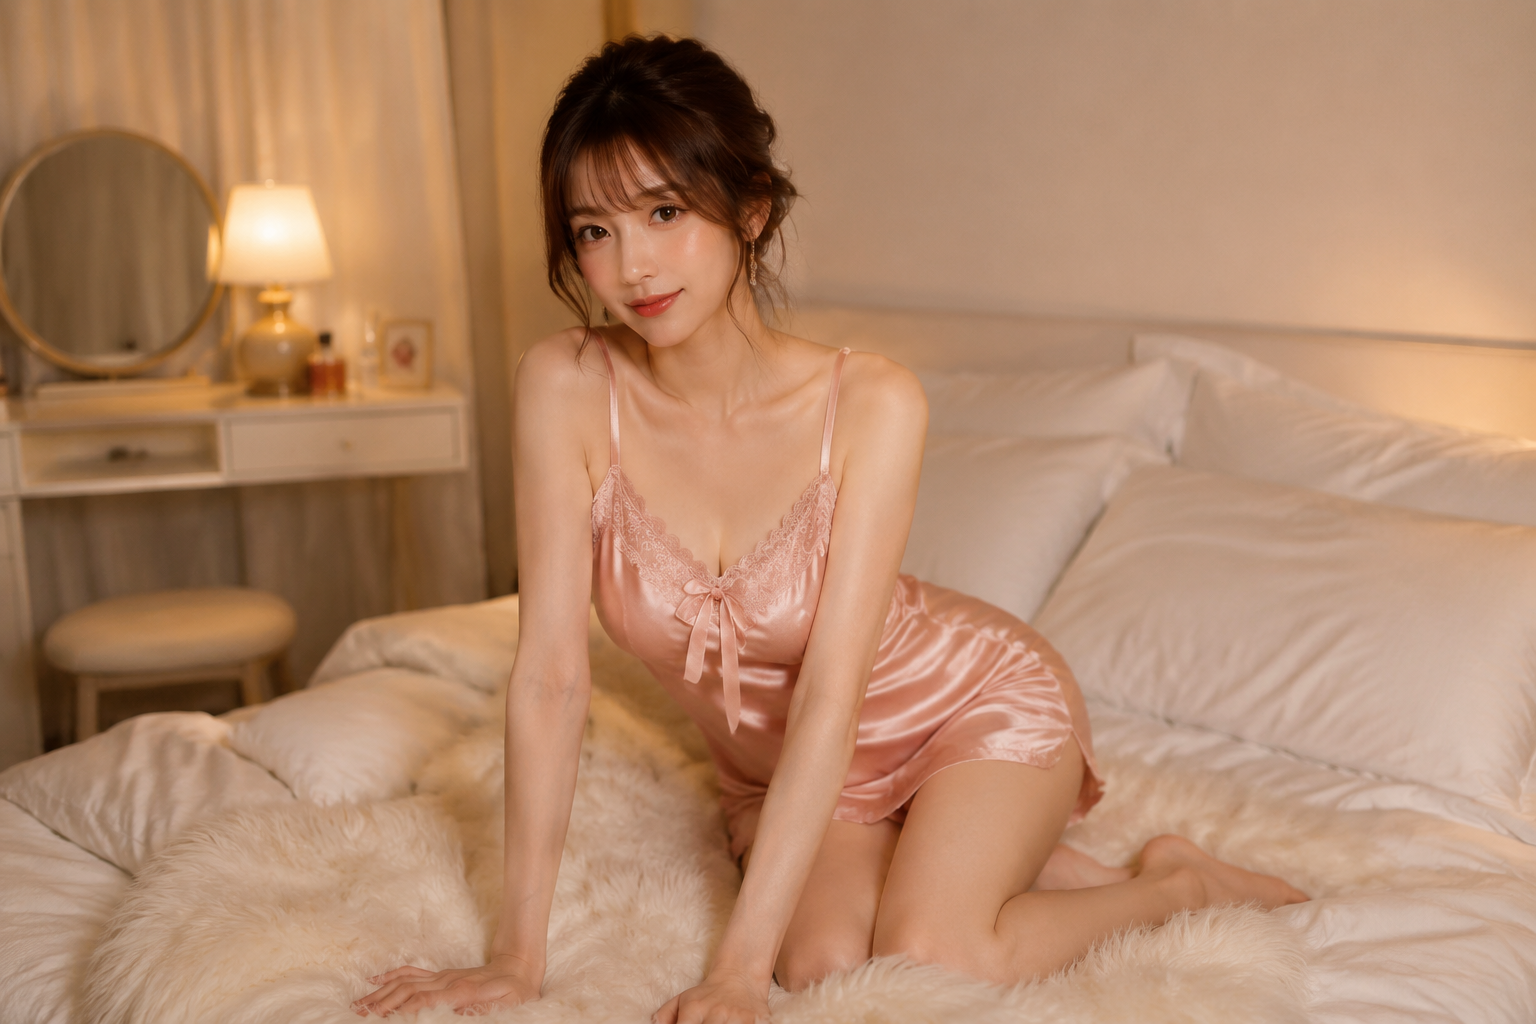
跪坐的双膝指向一侧,小腿向外侧轻微分开,身体重心落在脚后跟上——这是一个人体工程学上极不稳定的坐姿,需要小腿的肌肉持续维持平衡。但这条 Prompt 用了整整四个句子来描述这个极不稳定的姿态,对情绪词却一个字没写。
大多数角色反而不是写姿态而是写状态——「慵懒地跪坐在床边」「脆弱地环抱自己」「安静地低着头」。这些情绪标签是捷径,模型收到标签后直接从训练数据中调取一个预设的情感解码方案——常见的结果是,在脸上写满忧郁、肢体动作却完全中立。
这条 Prompt 的做法截然不同。它不写任何情绪词,只写骨骼的位置关系:双膝并拢在哪、小腿向哪侧分开、臀部坐在哪个位置、手臂从哪里绕过来、手掌握住哪里、头发遮住哪些区域。
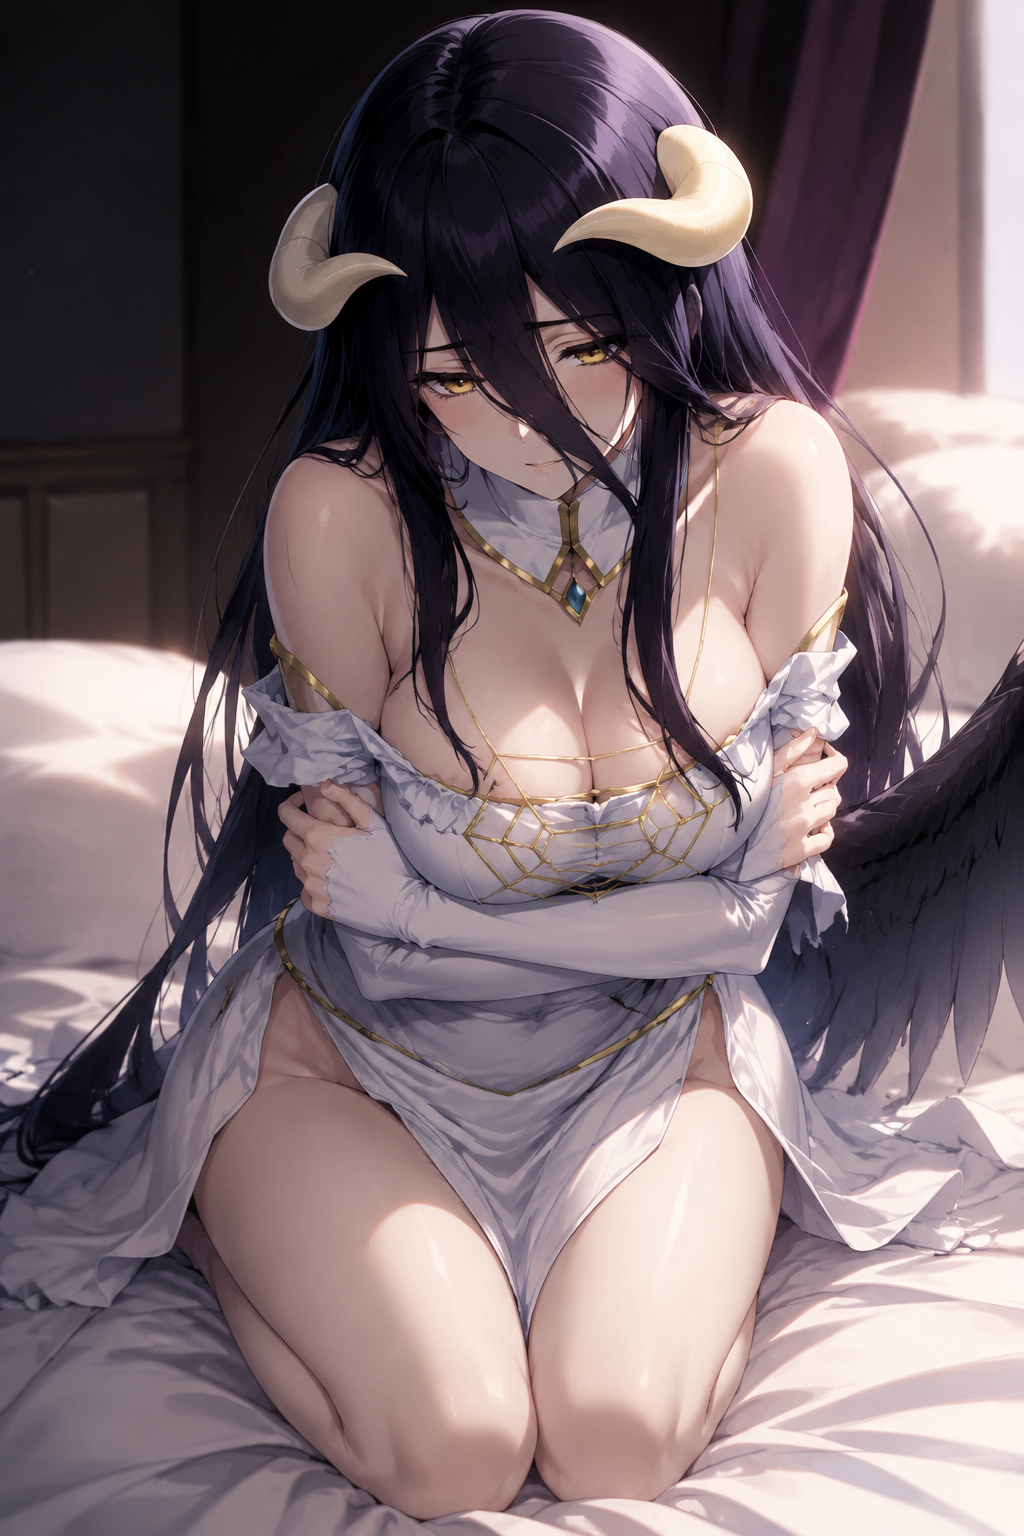
《overload》动漫中的雅儿贝德跪坐在床上或软榻上,双膝并拢,小腿向两侧轻微分开,臀部坐在脚后跟附近。双臂从胸下横向环抱身体与膝盖,手掌分别握住对侧手臂,上身略微前倾,肩膀轻轻内收。长发自然散落并遮住半边脸,头部微微低下,眼睛从发丝之间向上看向镜头。整体姿态收拢、克制、柔软,突出肩颈、胸部与腰线的层次,画面带有安静、暧昧、略显脆弱的情绪。
完整原文共 11 句,全部都是物理坐标——没有一个字直接写「脆弱」「色气」「安静」。这个策略可以称为「自体环构法」——用身体各部位的自锁型环抱构成一种闭合的空间关系,情绪不靠形容词注入,而是从骨骼的几何关系中自主浮现。
跪坐的姿态拓扑:非承重支点如何构成身体的自锁回路
这条 Prompt 的姿态核心不在上半身的环抱,而在下半身的跪坐结构。
「双膝并拢,小腿向两侧轻微分开,臀部坐在脚后跟附近」——三个动作定义了三个独立的关节约束点。双膝并拢和下跪是两个不同的概念:下跪是膝盖接触地面的姿态,但大腿和小腿的角度可以任意变化;双膝并拢后,两条胫骨以双膝为支点形成八字形张开,模型解码时必须在膝关节处同时解算两个角度——大腿角(大腿与躯干的夹角)和小腿角(小腿与大腿的夹角)。双膝并拢决定了大腿的对称性,小腿分开决定了小腿的独立性——两条骨骼链在膝盖处会合后分向两侧。这个结构在物理层面上形成了一个以膝盖为铰链的Y形承重结构。
「臀部坐在脚后跟附近」——这属于日式正坐(seiza)的变体,但与标准正坐不同:标准正坐的脚踝向上、脚尖相对,臀部坐在脚掌上;这里的臀部坐在脚后跟上,意味着脚掌平放在床上、脚背贴地、脚后跟位于臀部正下方。模型解码时,整个下半身的重量传递路径是:臀部 → 脚后跟 → 床面——这是一条垂直的力传递路径,与直立站姿的力传递路径(足弓 → 踝 → 膝 → 髋)完全不同。模型在训练数据中对于「臀部坐在脚后跟上」的姿态覆盖远少于标准坐姿,没有足够的默认姿态可以退守,只能按照骨骼精度逐关节解算。这就是这条 Prompt 的精髓:选择的姿态是训练数据边缘的,模型必须逐个关节解码,无法走捷径。
交叉环抱:双侧对称中的不对称
「双臂从胸下横向环抱身体与膝盖,手掌分别握住对侧手臂」——这组结构同时定义了手臂的两个作用:环抱(从胸下横向绕过)和自握(手掌握住对侧手臂)。
手臂环抱有三个层次。第一个层次是自锁——左手握住右臂不是装饰,是右手臂的力学约束:右臂被左手握住后,右臂的运动自由度从肩关节的全向旋转降级为肘关节的单轴弯曲;同理左臂被右手握住。两只手臂各自被对方的手锁定,形成无冗余的闭环约束,不同于交叉双臂(degree of freedom为2)或环抱膝盖(degree of freedom为1),自锁型自握是完全约束——手臂的自度为零。外物不介入,仅靠自身部件之间的关系完成锁定,正是「自体环构」的含义——身体是自己的脚手架。
第二个层次是手势的方向性——「从胸下横向环抱」定义了手臂的路径是从胸部下方水平穿过,而非从胸部上方。这个方向差异导致了对胸部的遮挡程度不同:上方环抱(双臂交叉在胸前)会使锁骨到胸口的区域完全被手臂遮挡,下方环抱使手臂位于胸部下方,胸部和领口区域完全暴露。在画面中,暴露与被遮挡之间的面积比大约是70:30,对肩颈至胸口的视觉扫描产生了由明到暗的层次过渡。
第三个层次是手掌的位置——「手掌分别握住对侧手臂」,这个点声明了接触位置在手臂而非肩膀或手腕。手掌与手臂的接触是前臂中段,肌肉最饱满的位置——手掌握住时产生的指压凹陷在肌肉表面形成微妙的阴影变化。模型在解码这个接触时,需要同时生成手掌的包裹形态和手臂的受力形变,接触精度的要求远高于两只手平行放置。
半遮面式眼神:发丝如何改变眼位的解码路径
「长发自然散落并遮住半边脸,头部微微低下,眼睛从发丝之间向上看向镜头」——这组声明不仅是视觉造型策略,更是模型解码层面的约束机制。
「长发自然散落并遮住半边脸」在解码层的表现是:面部区域的像素有一半被头发纹理覆盖,另一半完全裸露。头发颗粒的噪点会干扰面部解码的精度,模型在处理遮盖区域时优先保留高点——眼睛、鼻子、嘴唇——而把低点的面部平整度交给随机填充。结果是裸露的半边脸保留完整的面部语义,遮盖的半边脸保留面部轮廓但细节被发丝纹理覆盖。这种不对称解码的视觉效果恰好是遮挡式构图的核心魅力——隐去一半、强化一半。
「头部微微低下」——这个动作改变了面部的三维朝向。当头部平视时,面部平面垂直于视线,眼睛到镜头的光学距离均匀。当头部低垂时,面部平面向下倾斜,眼距在透视中缩短,眉弓到下颌的距离被压缩。模型解算低头面部时,默认的平视正脸编码被强制切换到俯视歪脸编码——输出精度下降的原因是面部训练数据中平视正脸占比最大(约80%),低头侧脸占比最小(约5%)。而「眼睛从发丝之间向上看向镜头」要求模型在低头的面部骨骼上反向安装「向上看」的眼球方向——脖子是弯的、脸是低的、眼球是朝上的——三个骨骼段呈现三向弯曲。
这个叠加的视觉结果很特别:被遮住的半张脸因为发丝的干扰而模糊,被放大的半张脸因为眼球的向上凝视而强化,观众的目光被这个不对称的视觉路径从画面边缘牵引到瞳孔中心——被遮住的部分制造期待,被放大的部分满足期待。
无声的情绪编码:当骨骼就是语言
文章开篇说过,这条 Prompt 没有一个直接的形容词来描述情绪。现在来验证这一点。
全文检测一遍就会发现:所有描述都是物理的——「并拢」「分开」「坐在」「环抱」「握住」「前倾」「内收」「遮住」「低下」「向上看」「收拢」「克制」「柔软」「安静」「暧昧」「略显脆弱」。15个描述词中最后3个是情绪词,出现在最后一句,且以「整体姿态」的归纳形式呈现——它们是对前三句物理描述的总结,不是独立注入的情绪标签。
模型先读到位置声明(前8句),再读到情绪归纳(最后1句)。顺序决定了模型在解码前三句时已经完成了骨骼位置的解算,最后一句的情绪归纳只是对上文已生成姿态的总结性命名。情绪词在这里不是注入,是描述——模仿了人类描述一个姿态时的观察顺序:「看到她这样坐(观察骨骼)→感受到安静脆弱(归纳情绪)」。模型在人类的观察路径中解码而不是在一个情绪标签中解码,输出的姿态不是「脆弱的样子」,而是「一个具体的姿态所自然散发的脆弱感」。
这也意味着如果模型在接收骨骼坐标之前就收到「脆弱」标签,解码顺序会翻转:模型先在训练数据中搜索与「脆弱」最匹配的预设姿态——通常是双手抱膝低头蜷缩,然后在这个预设姿态上微调骨骼。结果是模型输出的是「情绪标签的标准图」,而不是「这条 Prompt 所定义的独特姿态」。
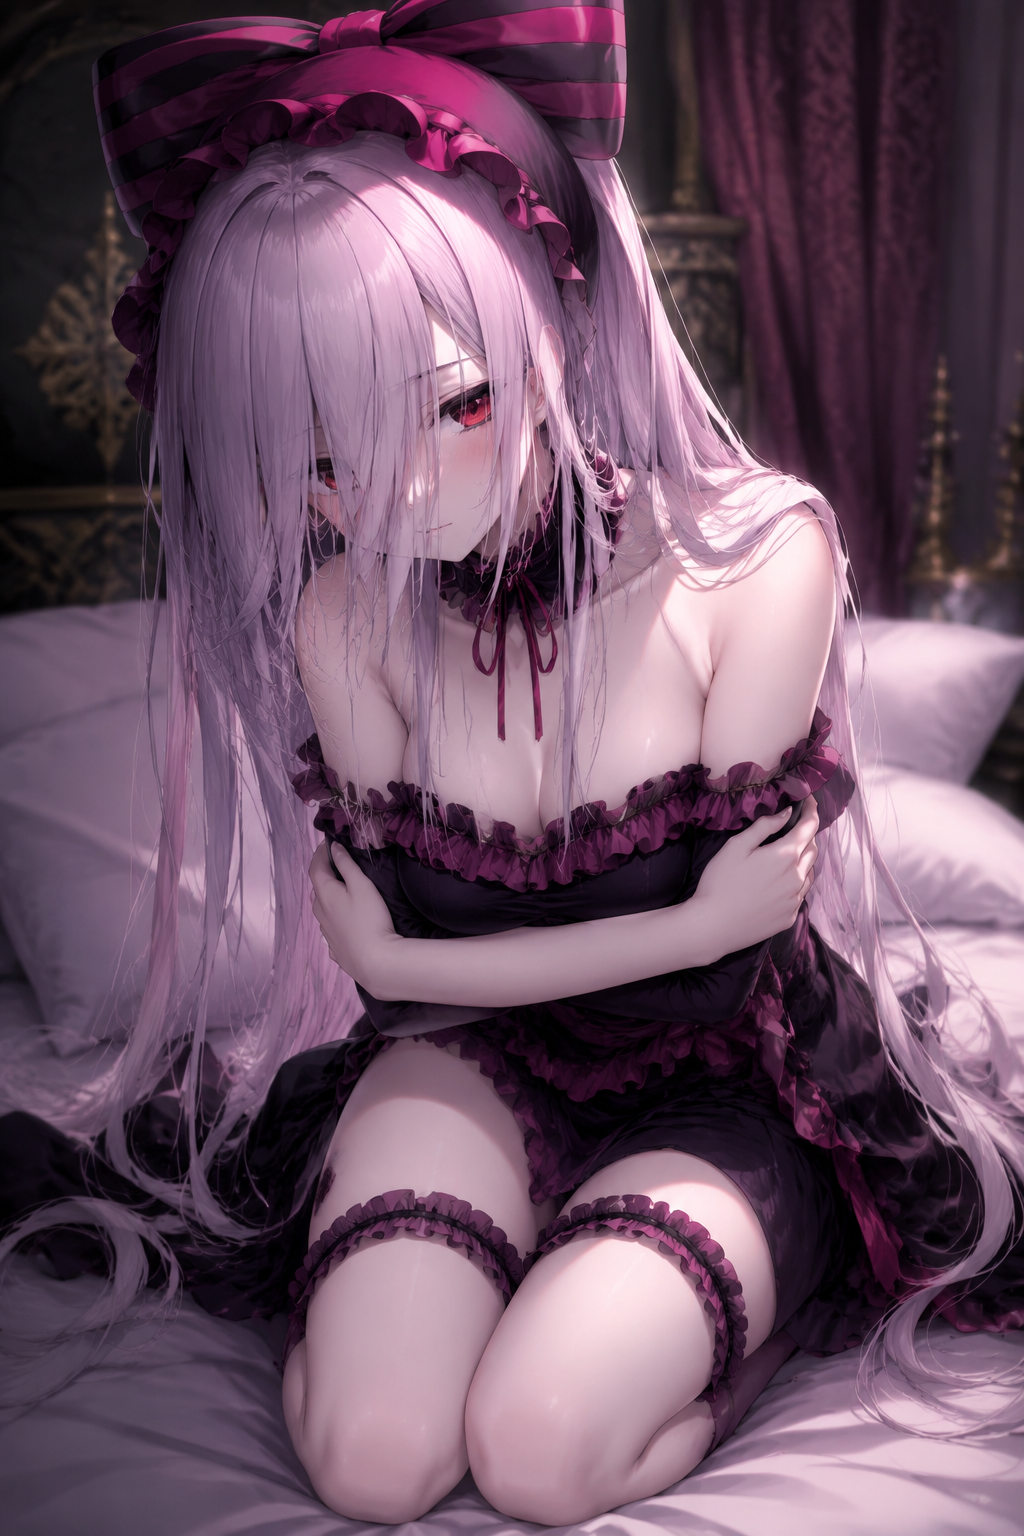
技术参数表
| 参数 | 推荐值 | 说明 |
|---|---|---|
| 下肢锚点 | 3 个(膝并拢/小腿分/坐脚跟) | 定义自下而上的力传递路径,消除默认坐姿编码 |
| 上肢结构 | 自锁型交叉环抱 + 自握 | 手臂自由度降为零的双向锁定闭环 |
| 环抱路径 | 从胸下横向穿过 | 控制手臂对胸部的遮挡面积比例(约70:30) |
| 遮挡比例 | 50%面部被头发覆盖 | 不对称面部解码:裸露半脸保留语义,覆盖半脸保留轮廓 |
| 头部朝向 | 低头 + 眼球向上 | 三段骨骼三向弯曲,解码难度最高 |
| 情绪声明策略 | 物理描述9:情绪归纳1 | 先声明位置后归纳情绪,情绪=姿态的尾注而非注入 |
| 姿态训练覆盖 | 边缘姿态(训练数据<5%) | 选择模型无默认退路的姿态,迫使逐关节解码 |
FAQ
Q:为什么这个Prompt不写雅儿贝德的标志性特征,比如恶魔角或黑翼?
没有写标志性特征是因为它们在模型解码中是强关联标签——当模型读到「雅儿贝德」这个角色名时,已经在训练数据中激活了恶魔角、金色瞳孔、黑翼、白发红瞳等一系列特征编码。这是角色名本身的解码优势:不需要额外声明。如果画蛇添足再写一遍「魔鬼角、黑翼」,反而可能因为重复声明导致特征的注意力权重过高,在输出中放大到不自然的比例。这条 Prompt 把宝贵的 token 全部留给姿态声明——角色特征靠名字激活,姿态特征靠位置声明。
Q:自锁型自握和普通交叉手臂在模型解码中有什么区别?
交叉手臂是双手分别握住另一只手的手肘外侧,自锁型自握是手掌握住对侧手臂。从力学上看,交叉手臂的lock节点在手肘(依赖于肘关节的摩擦力),自锁型自握的lock节点在手掌和手臂的接触面(依赖于手掌的握力)。模型解码前者时只需要生成两条手臂在肘部的重叠,解码后者时需要生成手掌包裹手臂的动态形变——解码精度和接触细节的输出要求完全不同。
Q:写「安静、暧昧、略显脆弱」会不会太直白?
这条 Prompt 中这三个情绪词出现在姿态声明之后,作用是归纳而非注入。顺序很重要:如果写在姿态声明之前,模型会先用情绪标签搜索预设姿态;写在姿态声明之后,模型已经在骨骼坐标中完成了解码。最后的情绪总结只是对已生成姿态的「命名」,不参与姿态的解码过程。这跟 FAQ 第一节的情绪声明策略完全一致——词序等于解码优先级的排序。
Q:这段Prompt全部用中文写,影响了画质吗?
没有。英文Prompt和中文Prompt对于模型来说都在同一编码空间内被分词器处理。模型并不「懂」中文或英文,只是从不同语言的token序列中提取语义向量。中文的动作描写在语义层面可以提供与英文等效的精度——关键在于token密度的充足性,而非语言本身。
评论0