
「辞条锚定术」的核心主张很简单——大多数 AI 人像 Prompt 的逻辑是”先建场景、再补细节”——森林、蕾丝婚纱、牵手奔跑,把画面元素写进去,然后祈祷模型拼对。
这条 Prompt 走的路完全相反。
它几乎不描述”发生了什么”。而是用一连串摄影术语构成语义锚场,让扩散过程自动向专业胶片人像的分布空间收敛。
电影质感的胶片摄影 专业人像摄影 大师构图 大师摄影 大师光影 光影美学 高颜值情侣 蕾丝婚纱 头纱 西装礼服 森林 牵手 奔跑 回眸 微笑 胶片感 近景 真人皮肤质感 细腻画质 最高画质 高级感 摄影杰作
这条 Prompt 的策略可以称为「辞条锚定术」——用摄影专业术语代替场景叙述来锚定画面质感和构图方向,把”描述画面”变成了”声明属性”。
从画面描述到属性声明:一条完全颠倒的控制链
传统 Prompt 写作的教学思路是:先设置主体、再补充环境、然后堆砌画质词。这条 Prompt 完全颠倒了这个顺序——它把”画质词”提到了和”主体描述”同等甚至更优先的层级。
具体来看,22 个词汇中,场景/动作类词只有「森林」「牵手」「奔跑」「回眸」「微笑」「近景」6 个,占比不到三成。剩余 16 个全是摄影风格和质感声明:「电影质感的胶片摄影」「专业人像摄影」「大师构图」「大师光影」「光影美学」「胶片感」「真人皮肤质感」「细腻画质」「最高画质」「高级感」「摄影杰作」。
这种配比不是偶然的。
扩散模型的语义空间中,专业摄影术语关联着高度集中的视觉模式。”大师构图”不是一句空话——模型在海量训练数据中学到的是:当”大师构图”出现时,画面大概率采用三分法、引导线、主体偏移黄金分割位等构图策略。”大师光影”同理,它对应着伦勃朗光、边缘光、高对比度阴影等具体的布光模式。
一句话总结:这些术语不是形容词,是视觉模式的索引键。
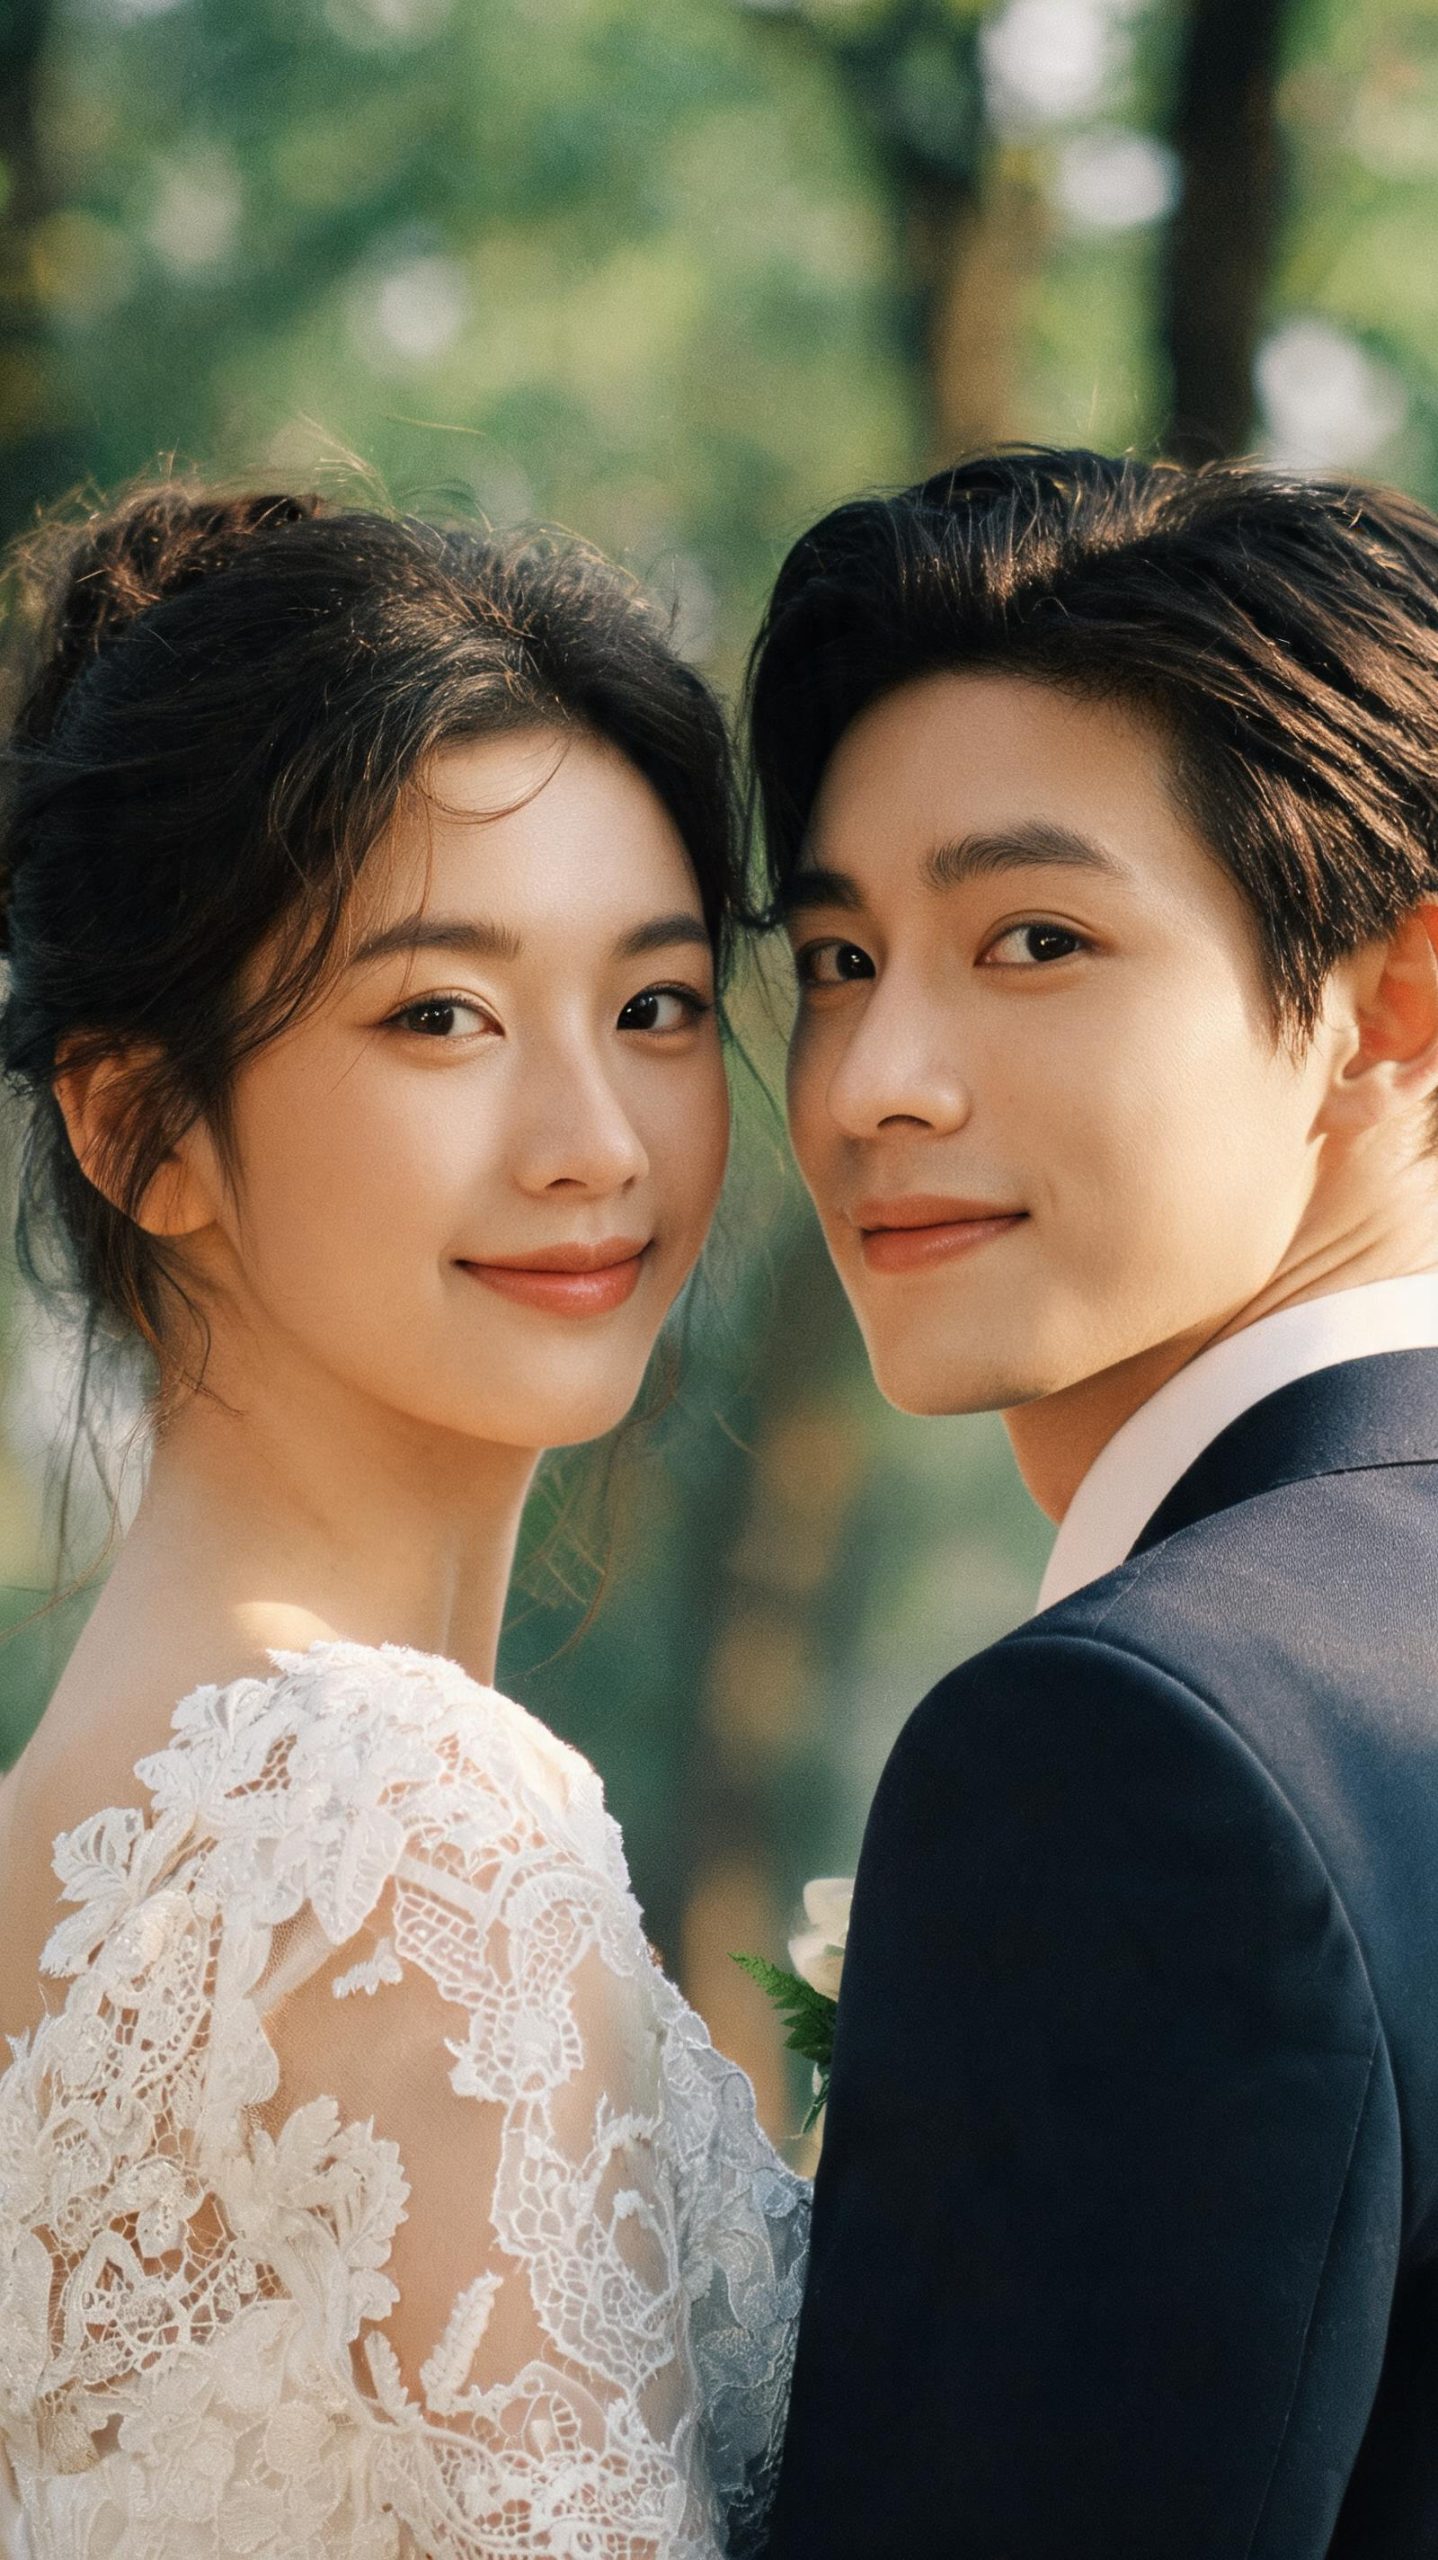
为什么「大师」前缀能提权:摄影术语的语义梯度效应
关键问题来了:为什么不写”三分法构图”而写”大师构图”?为什么不写”伦勃朗光”而写”大师光影”?
因为精确术语在 Prompt 里反而会产生语义窄化。
写”三分法构图”,模型就真的只往三分法上靠。但写”大师构图”,模型会激活一个更宽的构图模式分布——它涵盖了三分法、对称构图、框架式构图、对角线构图等多种策略,且倾向于选择在该场景上下文中最合理的一种。
这就是语义梯度效应:一个笼统但权重极高的摄影术语,比一个精确但权重普通的术语,能给模型提供更灵活的视觉决策空间。它同时起到了两个作用:提升画质基线(”大师级”意味着不出现明显的构图错误)和保留构图多样性(不锁定单一模式)。
「大师摄影」「大师光影」「光影美学」同理。「大师光影」让模型在伦勃朗光、蝴蝶光、环形光之间根据场景自动选择;「光影美学」则在更高维度上约束——不仅要打光”正确”,还要”美”。
这组”大师”前缀在 Prompt 里构成了一个语义杠杆:用一个词撬动了模型对多种专业摄影策略的激活,比逐个列举具体术语更高效。
双人动态的隐藏难度:为什么「牵手奔跑回眸」比看起来更复杂
表面上,Prompt 只用了三个动词来描述情侣动作。但在 AI 图像生成中,双人+运动是一个难度极高的组合:单一人物的大幅度动作已经容易导致肢体变形,双人同时进行不同动作——牵手、奔跑的步态同步、回眸的面部表情——意味着模型需要同时解析三个独立的姿态指令,并在同一帧内保持解剖学合理性。绝大多数 Prompt 写手遇到这种场景会加更多的约束词:”女生的手放在男生腰上””奔跑时两人步幅一致””回眸时眼睛看向镜头”。但加词就掉坑。每个精确约束都是一条必须被同时满足的条件,条件越多,扩散过程的可行域越小,最终结果越容易塌缩到畸形。这条 Prompt 的解法正好相反:不是增加约束,而是留白。
没有指定两人的相对位置、奔跑方向、回眸的角度。这正是辞条锚定术的精髓:用最少的动作关键词给出方向,让模型在摄影术语构成的语义场中自行填充合理的细节——如果 Prompt 写成”女生在右边回眸看向镜头,男生在左边牵手奔跑,两人向画面右侧运动”,反而会引发过约束,模型被卡在多个精确指令之间,最终收敛到一个扭曲的折中解。
另一个关键锚点是「近景」——它不仅定义了取景距离,还隐式约束了画面的空间深度。
近景人像意味着背景被压缩、人物占据画面主体、焦点在面部和上半身。这让”森林”从”需要精确建模的地面元素”降级为”柔焦的背景色块”。
模型不需要在森林的树木排列和奔跑路线之间做精度取舍。
胶片感的秘密:不只是后期滤镜,是色彩科学的语义暗号
「胶片感」「电影质感的胶片摄影」——这两个词在 Prompt 中的作用远大于”让画面偏暖色调”。在训练数据中,胶片摄影照片共享一组可量化的视觉特征:中低频色彩对比度、微妙的色偏、颗粒噪点的非均匀空间分布、以及轻微的暗角衰减——这些不是滤镜参数,是色彩科学的统计数据。当你写”胶片感”,模型在调色空间上激活了这组特征的联合分布。写”电影质感的胶片摄影”,则进一步指定了电影卷的方向:更高的宽容度、更克制的饱和度、以及 24fps 运动模糊暗示的叙事感。
这条 Prompt 里还有一个容易被忽视的词:「细腻画质」。
直觉上,「细腻画质」和「胶片感」是矛盾的——胶片以颗粒著称,细腻以光滑著称。但这两个词的共存制造了一种”高分辨率底片”的效果:高分辨率捕捉皮肤微纹理和毛孔,胶片颗粒在微观层面柔化边界。
精度和噪点不是对立面,是可以共生的两个平行层。
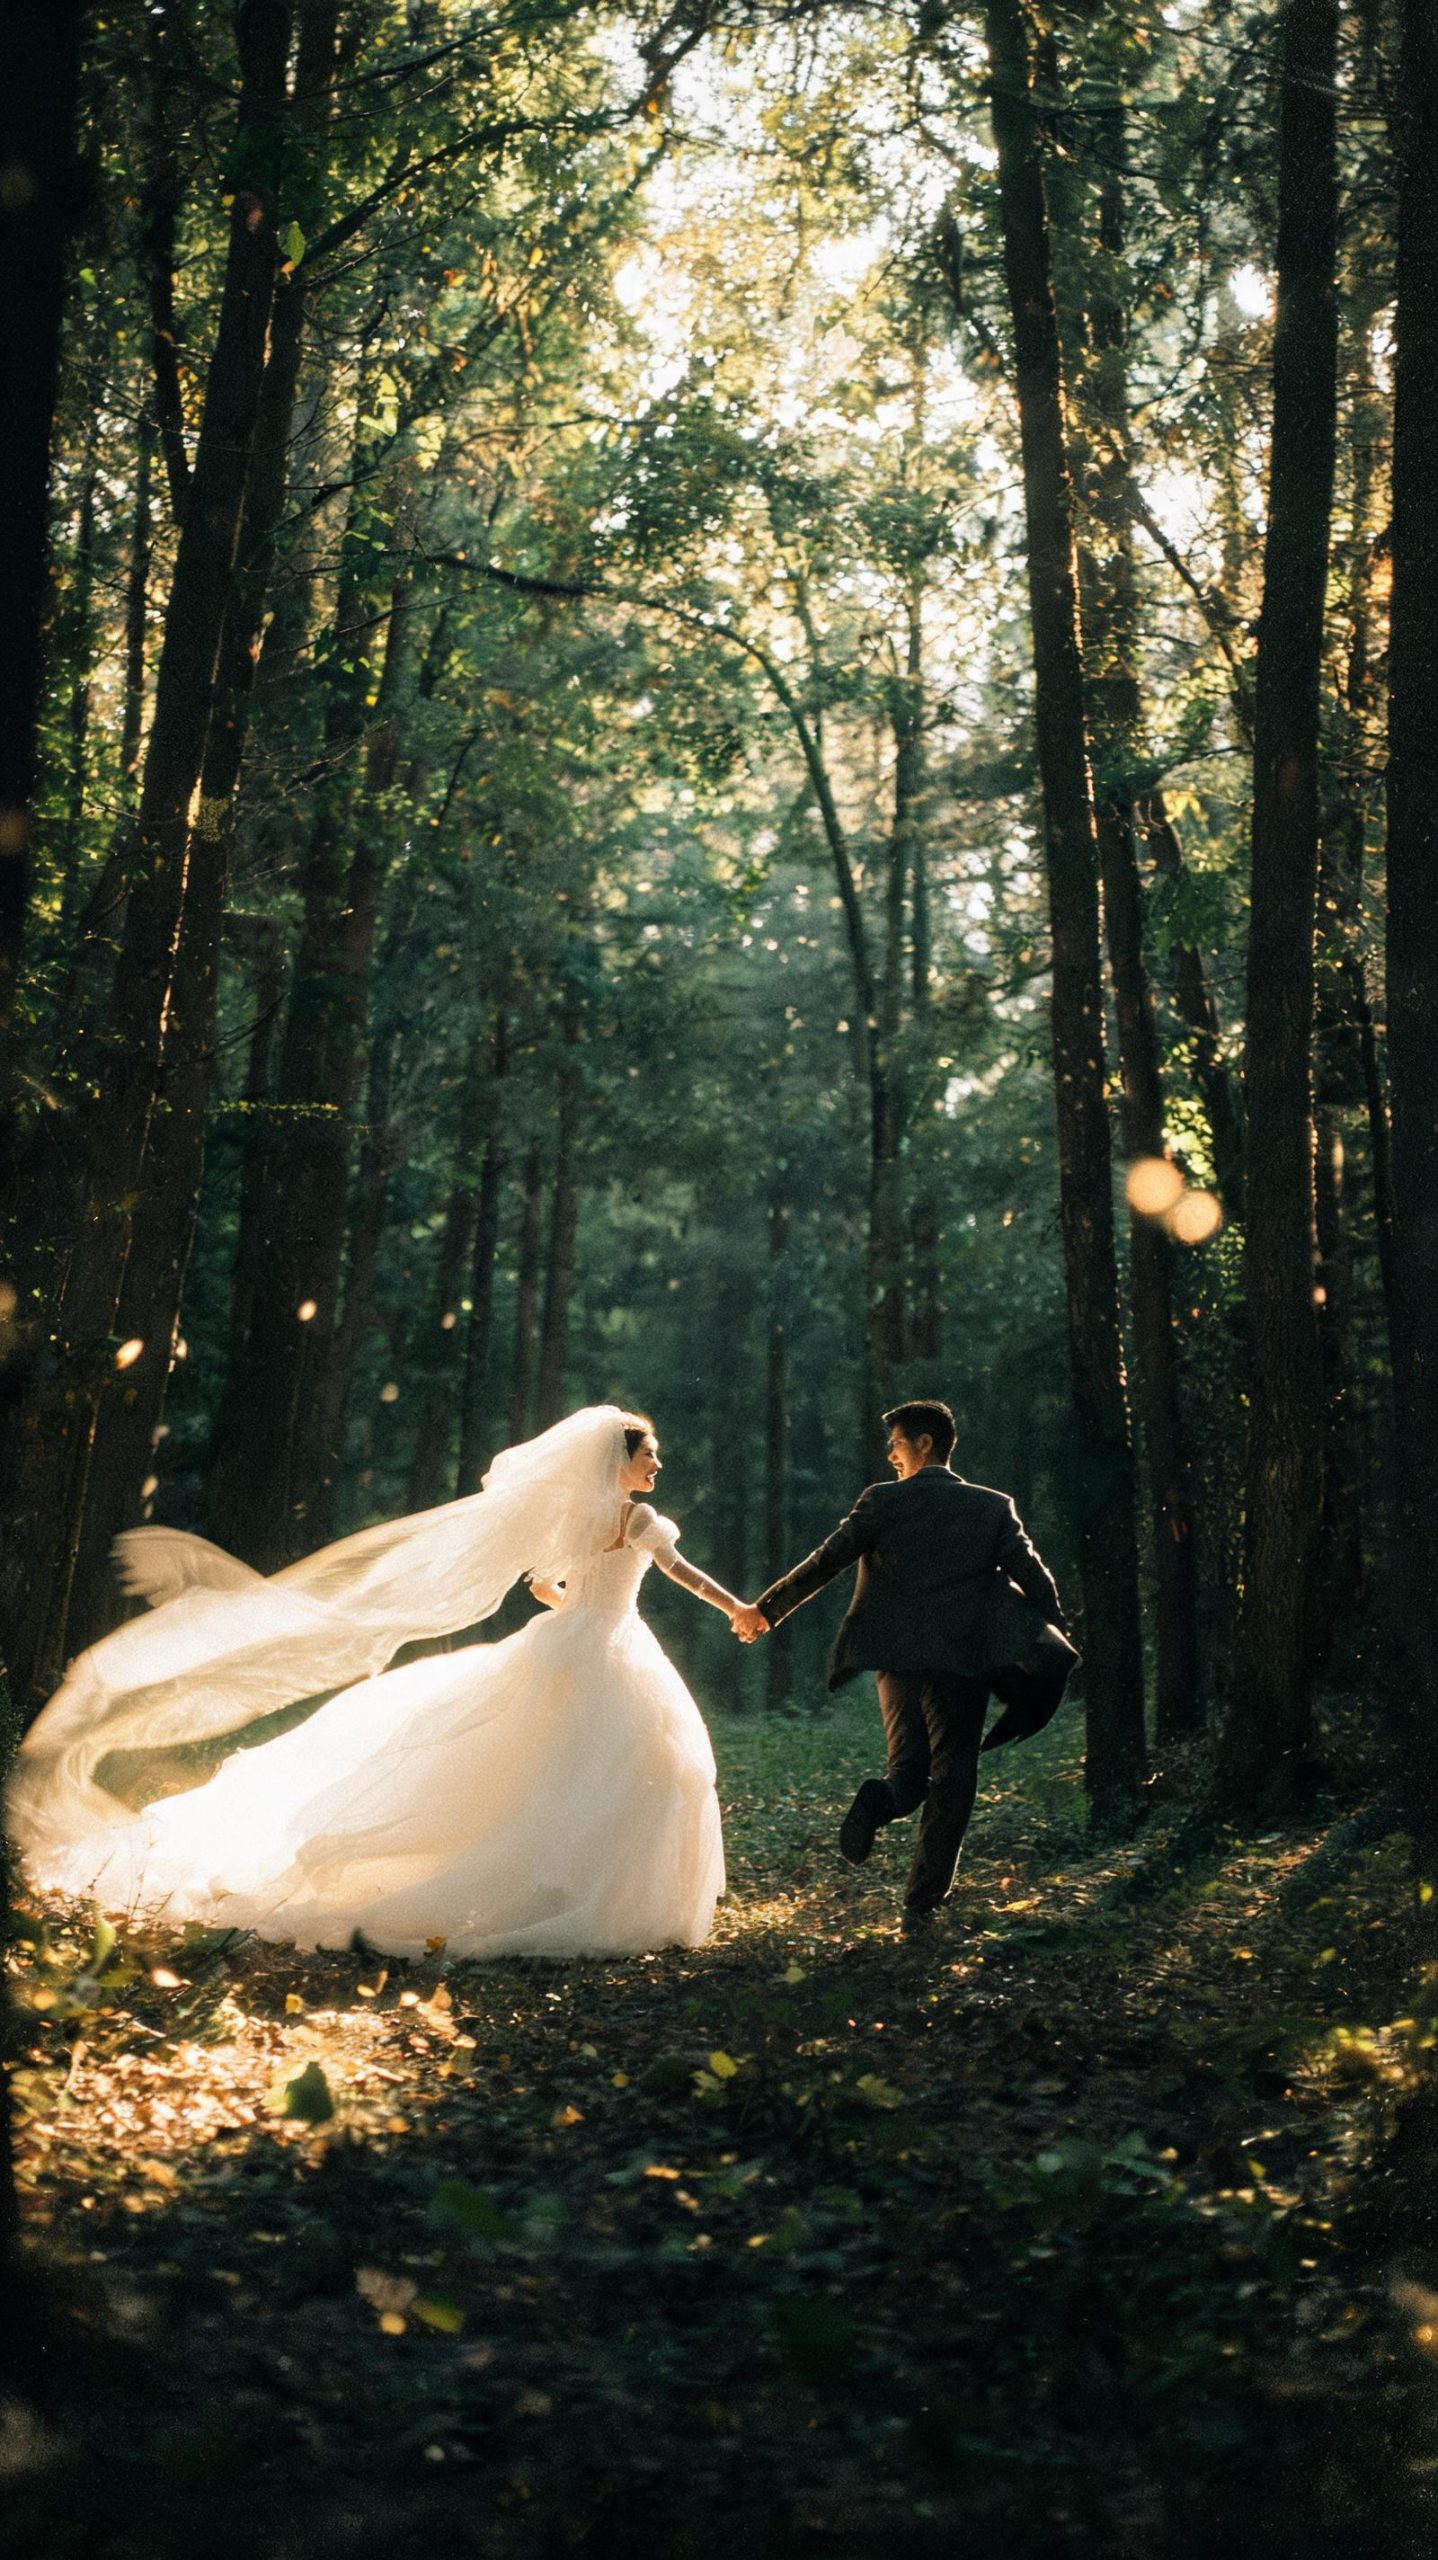
另一个关键视角:为什么这条 Prompt 几乎没有负面提示
大多数高级 Prompt 会附带一个长长的排除列表:不要畸形手指、不要塑料皮肤、不要 AI 脸……
这条 Prompt 完全没有负面提示。但它依然生效。
原因在于:当你用 22 个正向摄影专业术语构建了足够密集的语义锚场时,模型有了一条清晰的降噪路径——”我应该生成一张大师级电影胶片人像,而不是一个随机的森林场景”。在这条路径上,AI 绘画的常见缺陷(塑料皮肤、不自然光影、僵硬姿态)本身就不在目标分布内。
换句话说,用负面提示来排除缺陷,是在”堵漏洞”。用辞条锚定来声明品质,是在”填河道”——水自然流向更低的地方。
技术参数表
| 参数 | 值 |
|---|---|
| 模型 | doubao-seedream-5.0-lite |
| 分辨率 | 2K |
| 核心机制 | 辞条锚定术——摄影术语语义场替代场景描述 |
| 正向词条数 | 22 |
| 场景/动作词占比 | 27%(6/22) |
| 摄影风格词占比 | 73%(16/22) |
| 负面提示 | 无 |
| 构图策略 | 「近景」+「大师构图」双锚定,自动收敛到近景人像构图 |
| 双人动态策略 | 最小约束 + 语义场填充(3个动作词,无位置/方向限制) |
Prompt 完整附录
电影质感的胶片摄影 专业人像摄影 大师构图 大师摄影 大师光影 光影美学 高颜值情侣 蕾丝婚纱 头纱 西装礼服 森林 牵手 奔跑 回眸 微笑 胶片感 近景 真人皮肤质感 细腻画质 最高画质 高级感 摄影杰作
FAQ
Q:这个 Prompt 里”大师”出现了三次,是否冗余?
不是冗余。三次出现分别锚定三个独立维度:大师构图(二维空间排布)、大师摄影(三维空间中的焦距与透视)、大师光影(光照方向与阴影质量)。这三个维度在扩散模型中被编码在不同的注意力层,重复”大师”前缀实质是在不同通道上分别注入品质约束。
Q:如果我想换一个场景,比如城市街拍,需要改哪些词?
核心框架保持不变:保留所有摄影术语(大师系列、胶片感、细腻画质、高级感、摄影杰作)。只替换场景锚点——「森林」换成「城市街道」或「斑马线」,「近景」可改为「中景」获取更多环境感。双人动作词可根据需求调整。关键原则:场景/动作词保持在 30% 以内,不破坏术语密度的主导地位。
Q:这个策略适用于单人拍摄还是只适用于情侣双人?
单人拍摄同样适用,且效果更稳定——不需要处理双人动态约束。只需去掉「情侣」「牵手」等关系词,保留所有摄影术语即可。单人的优势在于「近景」+大师系列可以更精确地控制面部光影和构图,不产生双人空间交互的不确定性。
评论0