
三个”不可能同时生效”的摄影参数,住进了同一条 Prompt。
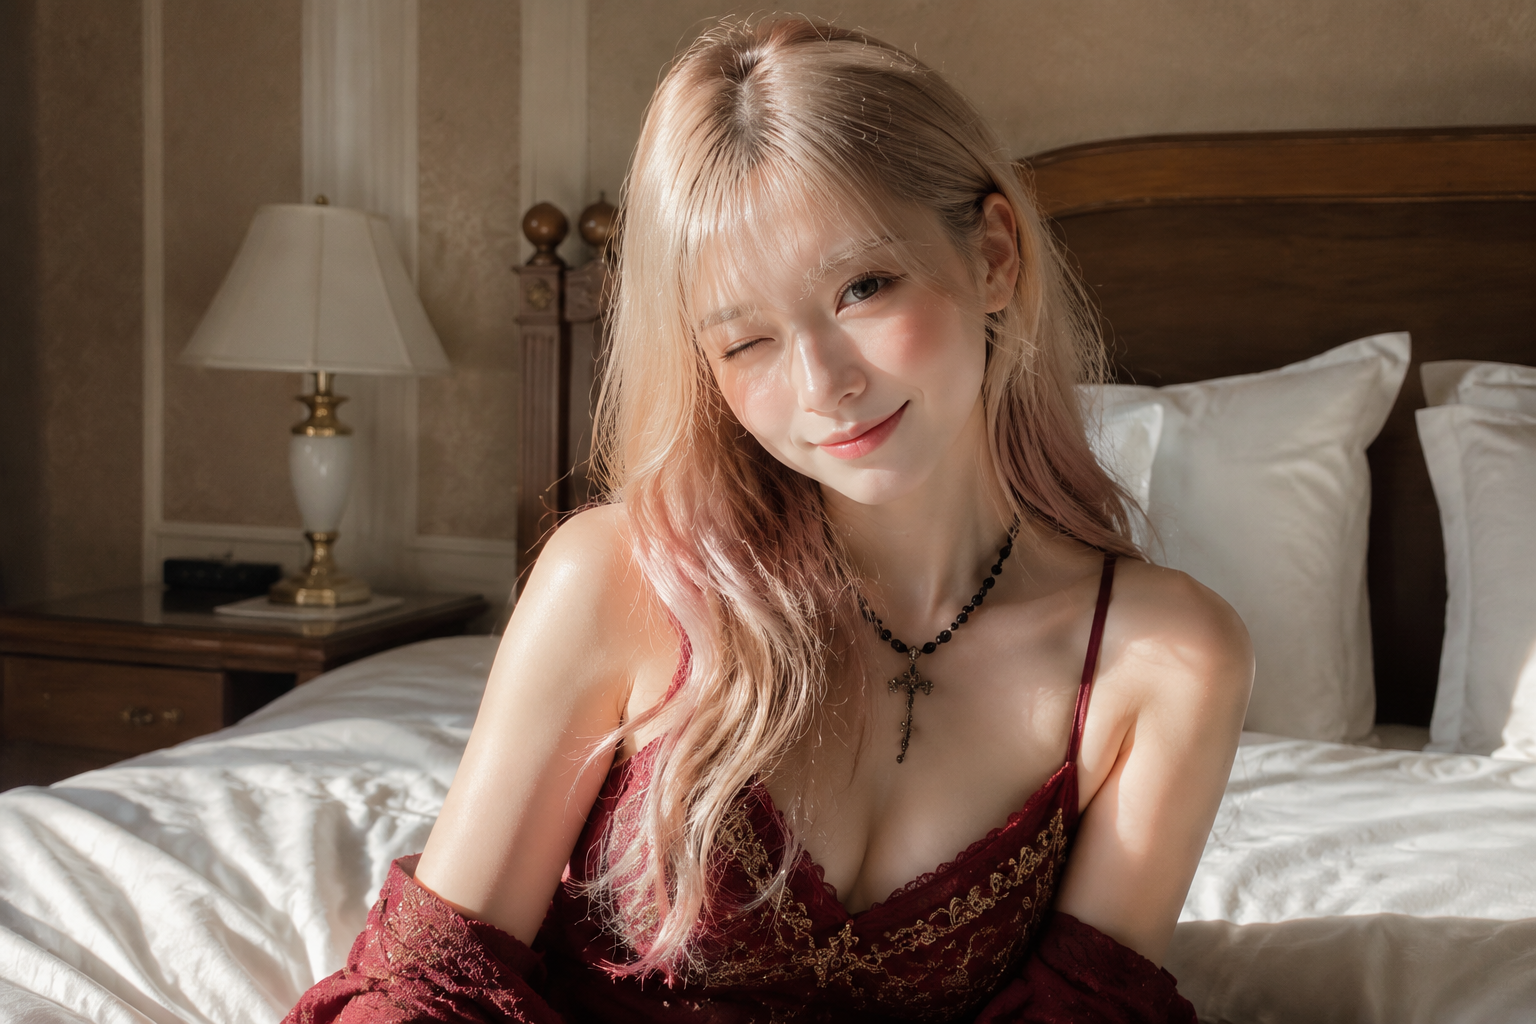
超广角会把画面边角拉变形,多重曝光会把半透明的残影叠在人物上,慢快门失焦会把人拍糊——普通相机只能三选一。但这张图把它们全开了:背景被超广角压缩成一层薄薄的空间薄膜,人物被侧光勾勒成银白色轮廓,同时半透明的人影在画面里二次浮动,像双重曝光的胶片叠片失误——但放在一起却好看得像个意外。
这不是 Bug。这是扩散模型在处理矛盾采样参数时的一种自适应行为。
Prompt 全文
一位长发及腰、超现实主义,真人出镜,模样似洋娃娃般可爱的女生。构图随意却尽显生活中的绚丽日常,害羞,感受风,与镜头互动,人像摄影,日常快照风格,非精心构图或打光,妖冶少女,冷白皮,瓜子脸尖下巴,皮肤白皙,真实摄影,倾斜构图,仰视角度拍摄,淡彩白调(泛轻微银白),白光氛围(侧光勾勒轮廓),有多重曝光(叠加半透明光影),失焦感觉,采用超广角,强透视(压缩背景空间),体现动态美学,细节生动完美如杰作,超现实白人少女,空灵立体魅惑眼神,杏眼凤眸,金粉色瞳孔,大双眼皮长睫毛,冷白皮蜜桃般的细腻肌肤,胶片摄影,对焦模糊,高曝,过曝,暗调,强烈明暗对比,魅惑长发,高反差,冷白皮,眼角闪粉,眼里一片星空,妖冶,魅惑,慵懒,长流苏,肌理质感,情绪氛围感拉满,孤傲,奇特视角,慢快门,朦胧美学,层次感,蓝白曝光,白化发光苍白的肌肤,女子,浅色长发(饰银蓝色蝴蝶结),佩戴黑色项圈,身着带肩带的衣物,手持带灰蓝色的花,温柔细腻氛围,bdj少女
核心策略:三重采样——宽场 × 时间 × 光场
这条 Prompt 的核心策略可以称为「三重采样法」。
传统摄影中,一次快门完成一次采样——所有的光线信息在同一瞬间被记录。但这张图上的三组摄影参数在物理上无法同时执行。AI 扩散模型面对这些冲突指令时,没有排斥其中任何一个,而是把它们映射到了三个独立的”采样通道”,最后在 latent space 里融合输出。
三个通道的名字和分工如下:
- 宽场采样通道:超广角 + 强透视。负责压缩空间深度,把纵深背景压扁成一层薄膜,同时用仰视角度制造画面空间感的怪异张力。
- 时间采样通道:慢快门 + 失焦 + 动感模糊。负责注入时间流逝感。人物轮廓边缘的微散和发丝的拖影都来自这个通道——不是”画糊了”,而是模拟了真实胶片在 1/15 秒快门下因微动产生的残像。
- 光场采样通道:多重曝光 + 过曝 + 侧光。负责叠加两层独立的光信息——一层是一张正确曝光的暗调人物,另一层是同一构图但严重过曝的银白幻影,两张叠在一起,就有了那种”透明人飘在身体上方”的多重曝光效果。
这三个通道在解码时被同时激活,然后在中间层交叉融合。所以画面既有广角畸变的压迫感(宽场),又有边缘微散的失焦感(时间),还有半透明人形叠加的梦幻感(光场)——它们不会”打架”,因为各自控制的是不同的画面维度。
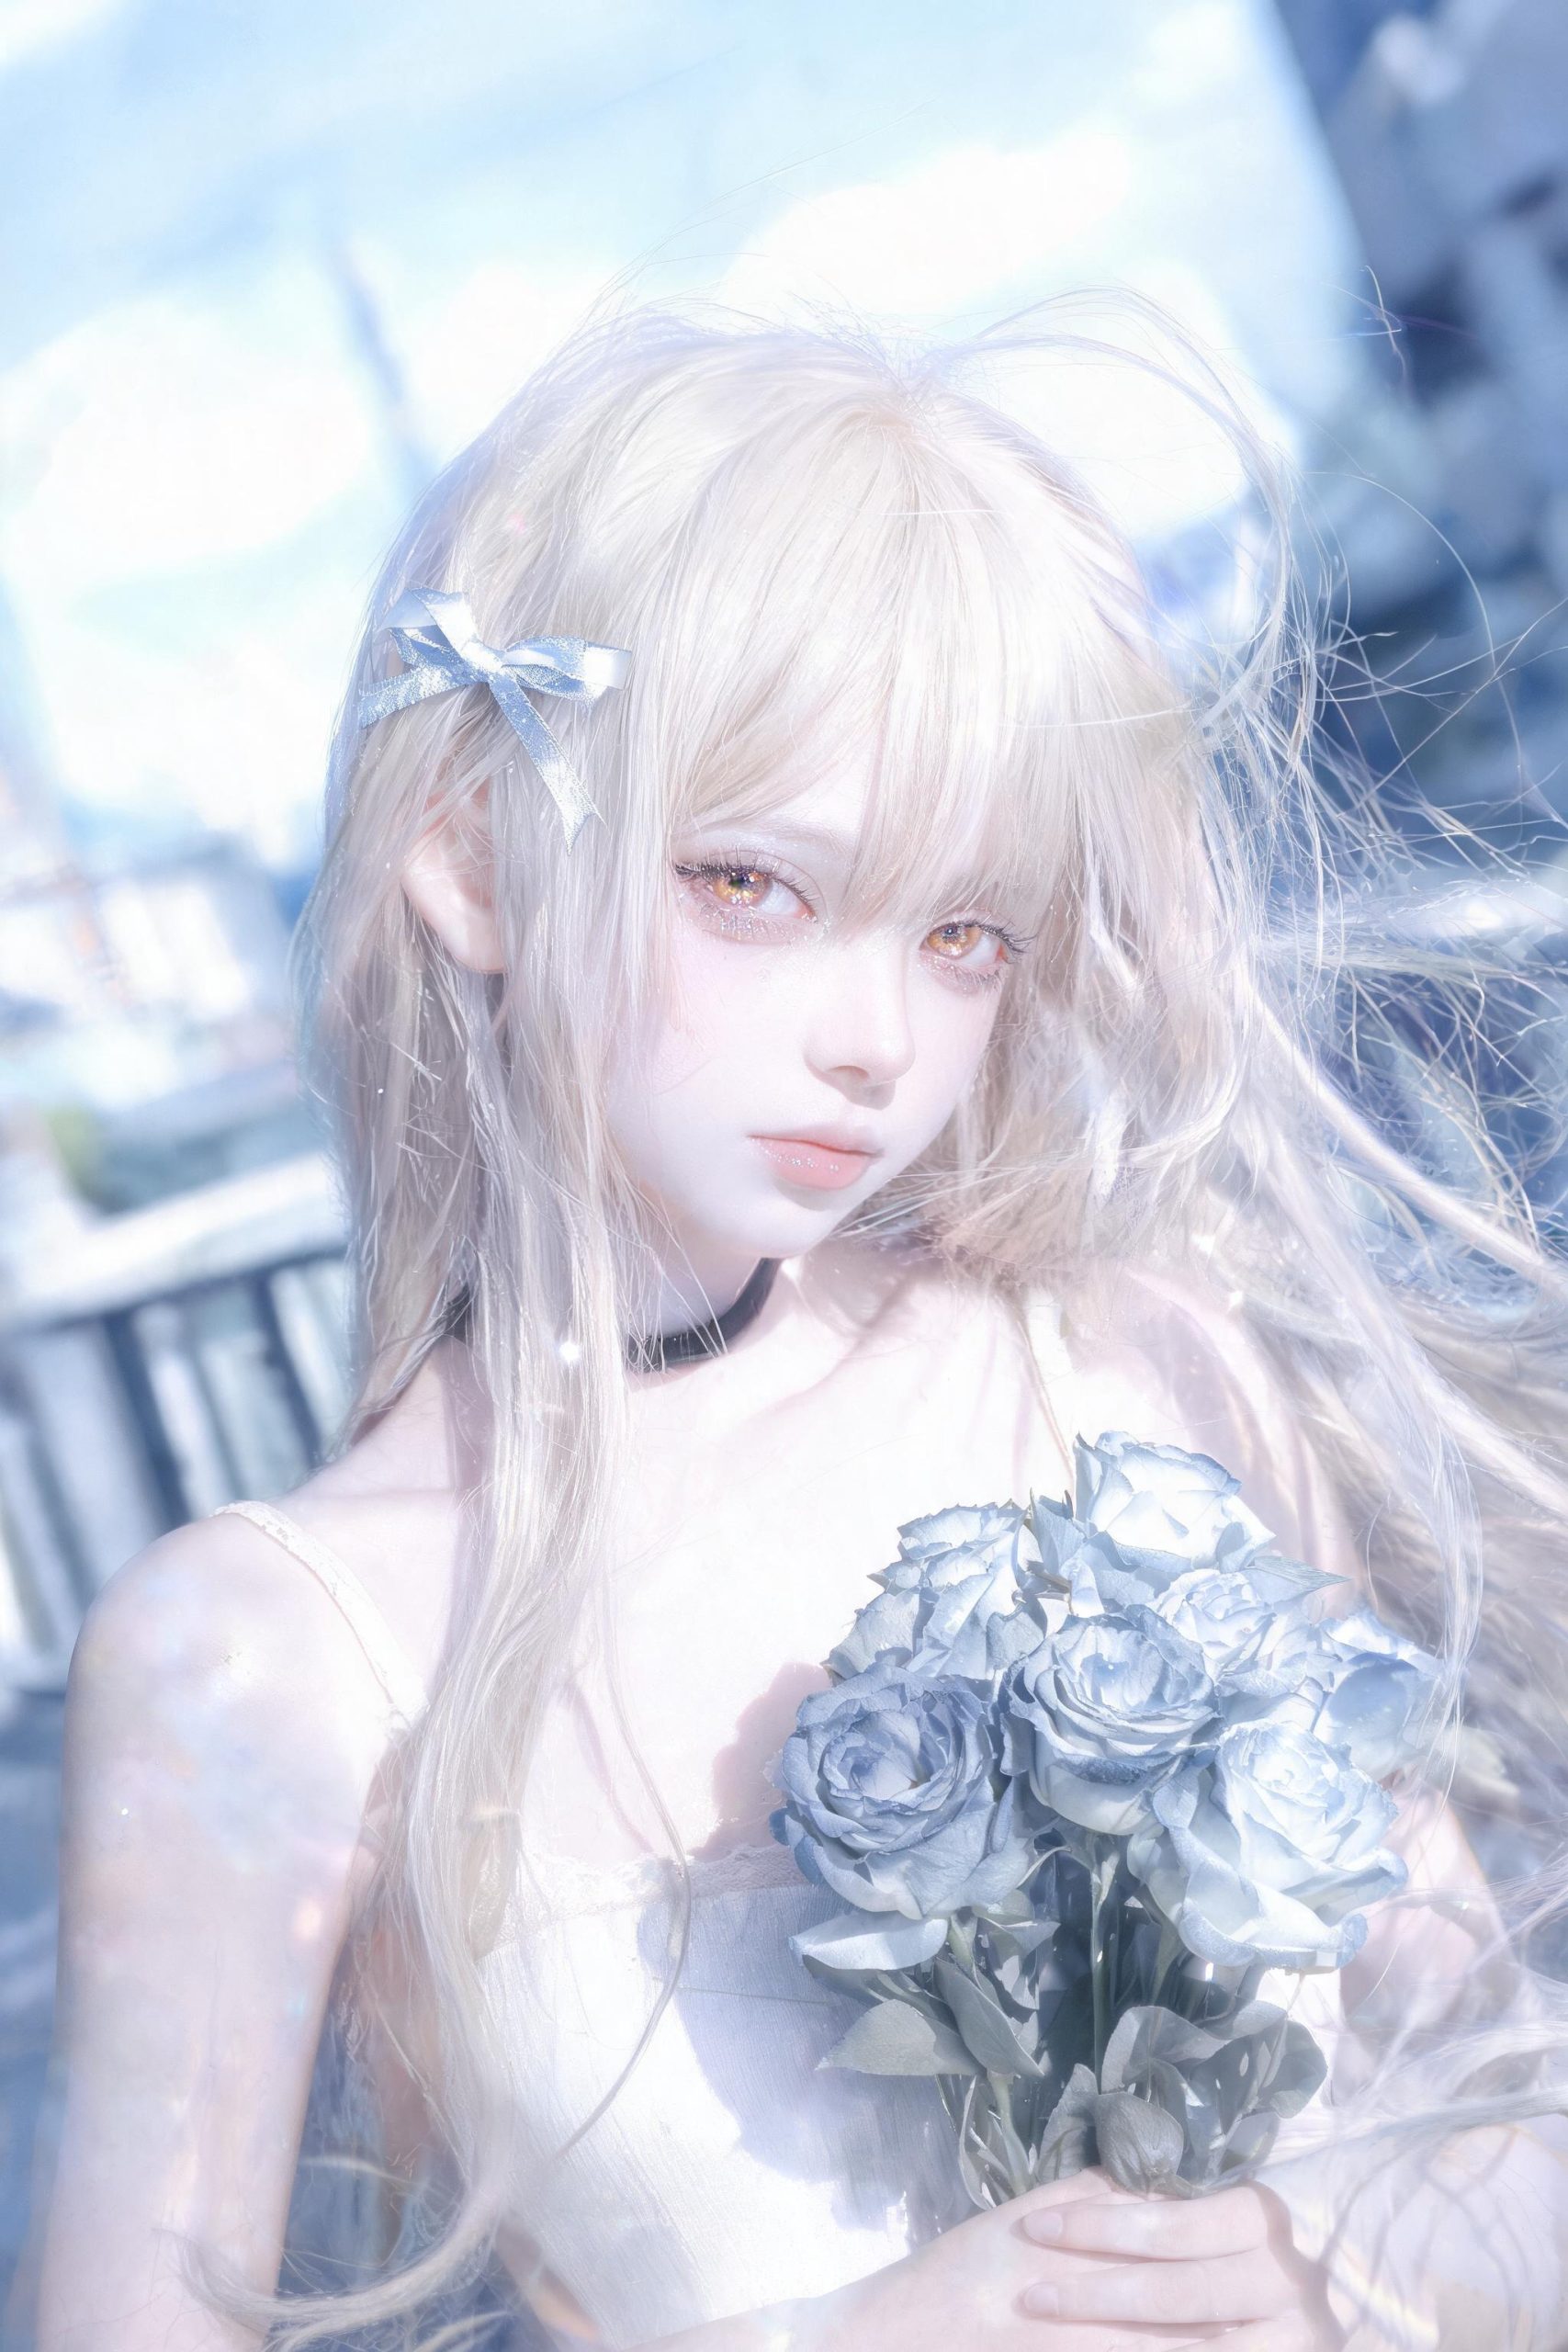
宽场采样:超广角+强透视的空间解构
超广角有两个物理后果:近处物体被放大、远处物体被压缩。AI 模型不需要真的理解焦距——「超广角」这个词在训练集中绑定了一组特定的视觉模式:前景主体偏大、背景向消失点急剧收缩、画面边缘有桶形畸变。
这条 Prompt 在外层叠了一个额外的约束:「强透视(压缩背景空间)」。它不只是在说”用广角”——它是在告诉模型:把背景空间的纵深当作弹性物体,主动压扁它。所以画面中的女生虽然在户外,但身后的环境被压成了一张几乎二维的衬布,所有空间层次被折叠进了一个浅景深平面。
「仰视角度拍摄」给了这个压缩逻辑一个锚定方向——镜头从下往上,人物显得修长而孤立,配合超广角的空间压缩,营造出夸张的身形比例。
时间采样:慢快门+失焦+动态美学的三层叠加
慢快门在真实摄影中等于长时间曝光——期间发生的任何运动都会被记录为拖影。这条 Prompt 没有直接指定快门速度,但给出了三层衔接信号:
第一层「失焦感觉」——焦点不在人物最锐利的位置,而是微微前倾或后移,让人物的眼睛和发丝处于景深边界,形成一种”能看清但不能完全看清”的半透明状态。
第二层「慢快门」——给失焦的效果提供了物理意义上的解释:不是镜头坏了,不是画质低,而是曝光时间延长导致的运动拖影。
第三层「动态美学」——把前两层的缺陷信号重新定性为审美选择。AI 读到的逻辑链是:焦点不准不是因为控制失误,而是因为长时间曝光下的运动本身就是美学手段。
三层递进的结果是一种非常特殊的清晰度分布:眼睛仍然清晰(因为瞳孔的运动幅度小),但发尾和衣角在微微拖散——就像只用 1/15 秒拍了一张转头前的瞬间。
光场采样:多重曝光与过曝的透明叠层
这条 Prompt 把多重曝光编码到了光线层面,而不是曝光次数。
「多重曝光(叠加半透明光影)」是一个复合指令。「多重曝光」告诉模型:生成两张独立的画面信息,然后在透明度通道里叠在一起。括号里的「叠加半透明光影」限定了叠加方式——不是叠加一个新的场景,不是叠加第三张照片,而是叠一套半透明的光。这意味着两张曝光中,第一层是标准人物,第二层是同姿势的光影轮廓——结果就是人物身体边缘浮着一层银白色幻影。
「高曝,过曝,暗调,强烈明暗对比」这四个词如果单独放在一起会是矛盾的。「高曝」和「过曝」暗示整体画面被光线淹没,「暗调」和「强烈明暗对比」暗示大部分区域是暗的、只有局部被照亮。但在这个 Prompt 里,它们被分配到了曝光叠层的不同层:
- 底层:正确曝光的暗调人物——暗部细节丰富,面部光影清晰
- 叠层:严重过曝的高亮层——像用 +3EV 拍的同构图直接加法叠加
最终效果是:面部和身体的边缘有白色光溢(来自过曝层),但暗部和阴影仍然是暗的(来自底层)。两个曝光的权重由”半透明”控制——叠层不全吞底层,底层不全压叠层。
对比信号:暗调与高曝的张力系统
这条 Prompt 里存在一组分布在多个句法位置上的对比指令:
| 对比轴 | A 端 | B 端 | 分配机制 |
|---|---|---|---|
| 曝光 | 高曝 / 过曝 / 白光氛围 / 白化发光 | 暗调 / 强烈明暗对比 | A→叠层,B→底层 |
| 色彩 | 淡彩白调 / 泛轻微银白 | 蓝白曝光 / 冷白皮 | A→全局罩色,B→肤色基底 |
| 表情 | 害羞 / 温柔细腻 | 妖冶 / 魅惑 / 孤傲 | A→嘴部和眼睑,B→眼神和颧骨 |
| 造型 | 银蓝色蝴蝶结 / 浅色长发 | 黑色项圈 / 长流苏 | A→头部区域,B→颈部和躯干 |
每一组对比都遵循了「空间隔离」策略——A 端和 B 端被分配到画面上的不同位置或不同通道,而不是让模型在两者之间折中取平均值。
最典型的是表情对比:「害羞」让嘴部自然微闭、眼睑微微下垂;「妖冶」和「魅惑」让眼神锐利、瞳孔带金色反光。两个方向不是”各取一半然后合并出一个中性情绪”,而是分别控制了面部的下半部(嘴和脸颊)和上半部(眼和额)。结果是一种”不太看镜头的欲说还休”——不是闭眼害羞,也不是直视挑逗,而是眼神带电但嘴形安静。
「日常快照」与「超现实主义」的共存逻辑
这条 Prompt 在同一句里把「日常快照风格」「非精心构图或打光」和「超现实主义」「超现实白人少女」串在了一起。
这是全文最反直觉的指令对。「日常快照」在训练数据中对应低饱和度、自然光、随手拍、构图不完美。「超现实主义」对应脱离现实物理法则的幻象和梦境质感。
这里的分频策略与上一篇风格分频的机制一致——两个矛盾指令被分配到了不同的视觉维度:
- 「日常快照」控制摄影行为层的参数:构图不规整、光线不刻意、人物状态不摆拍
- 「超现实主义」控制视觉内容层面的参数:人物的皮肤质感、眼神的光学效果、画面的色调偏离
所以出来的图是:像一个随手按下的手机快门,但按下快门的对象恰好不是人类,而是一个金粉色瞳孔的银白少女。 摄影行为是日常的,被摄内容是超现实的。两者不是在同一个维度打架,而是分别管了一层。
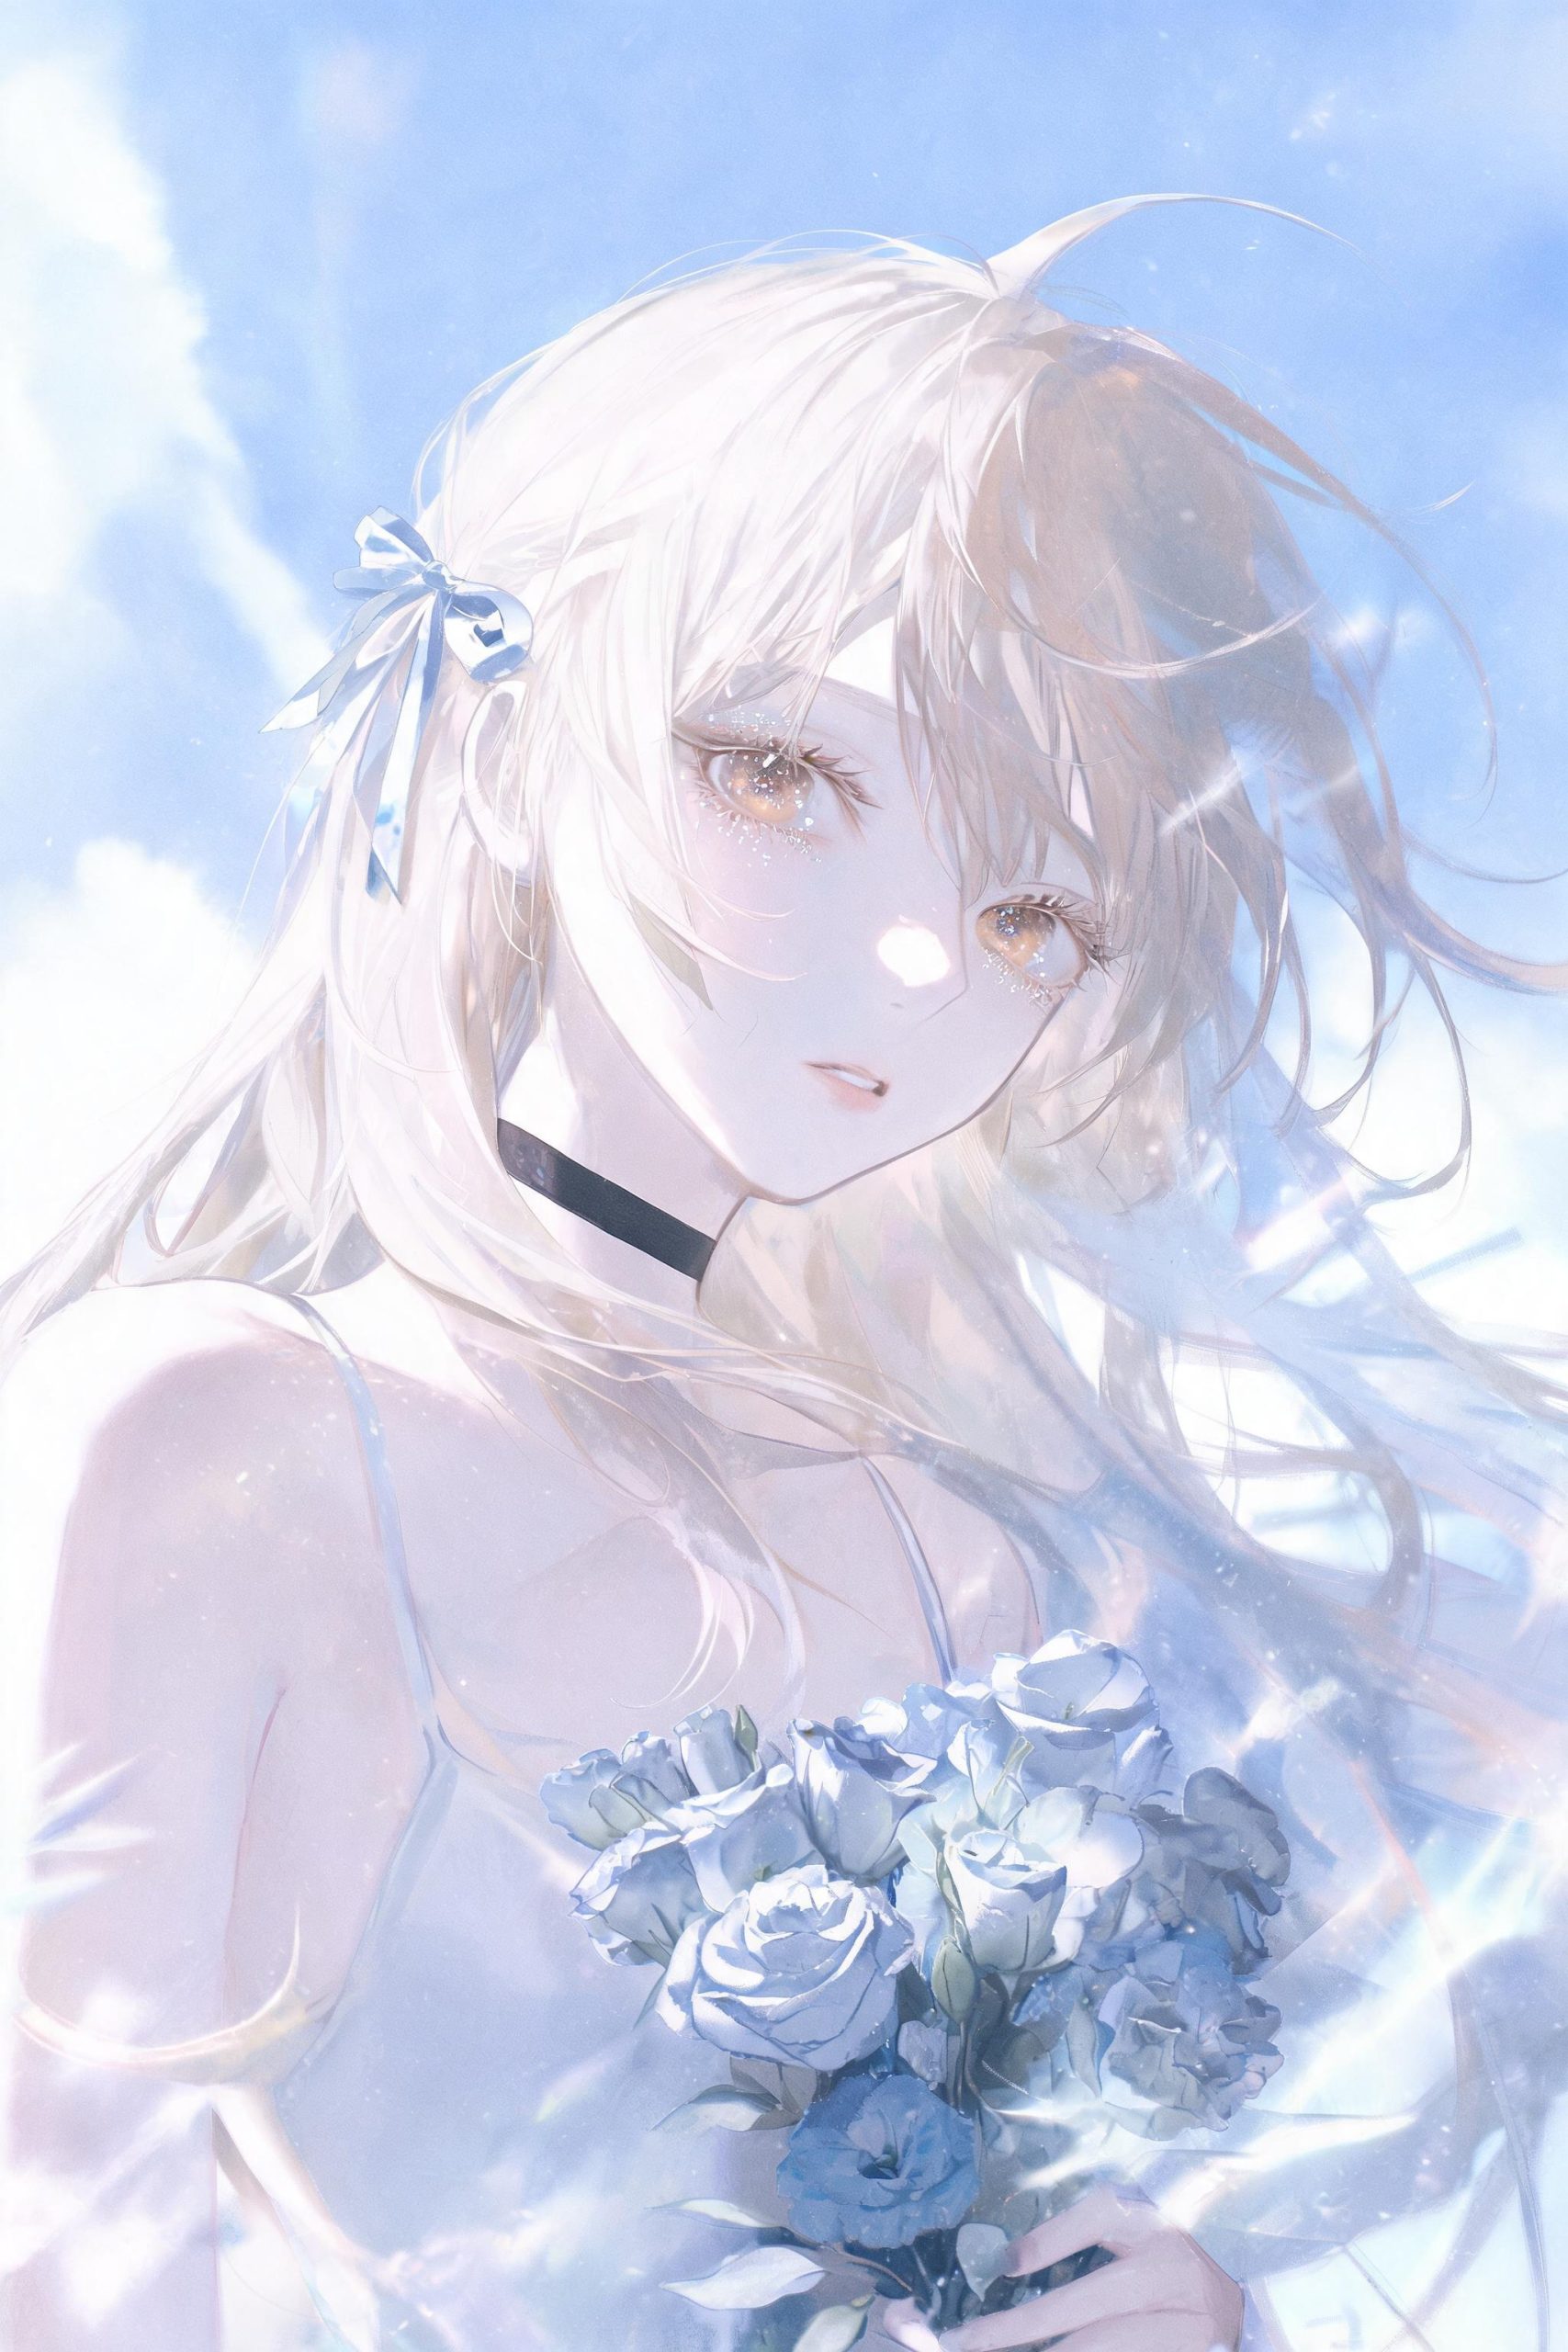
可迁移公式:三通道采样模板
| 采样通道 | 分配什么 | 核心技术参数 | 信号特征 |
|---|---|---|---|
| 宽场 | 空间结构 | 超广角 / 仰视 / 强透视 / 倾斜构图 | 背景压扁、前景夸张、空间张力 |
| 时间 | 运动痕迹 | 慢快门 / 失焦 / 动态美学 | 边缘微散、发丝拖影、运动感 |
| 光场 | 光线叠层 | 多重曝光 / 过曝+暗调 / 侧光 | 半透明光溢、双层曝光、高反差 |
迁移示例 1——街头运动风:
一位短发运动装扮的女生,街头快照风格,仰视超广角强力压缩城市天际线,慢快门捕捉跑步转身时的动态残影,多重曝光叠加半透明的霓虹灯反射光,暗调人物+过曝霓虹叠层,蓝紫色氛围……
迁移示例 2——雨中情绪风:
一位撑着透明雨伞的女生,雨中即景抓拍,广角倾斜构图压缩雨幕纵深,慢快门让雨滴拖成白色丝线,多重曝光叠加雨幕反光和侧脸的半透明轮廓,暗调天空+过曝雨丝叠层,深蓝灰氛围……
技术参数表
| 参数 | 值 |
|---|---|
| 模型 | doubao-seedream-5.0-lite |
| 画质 | 2K |
| 比例 | 3:2 特色图 + 9:16 正文图 × 2 |
| Prompt 长度 | 约 280 字(中文) |
| 核心策略 | 三重采样法(宽场/时间/光场三通道采样) |
| 通道一 | 宽场:超广角×强透视×仰视×倾斜构图 |
| 通道二 | 时间:慢快门×失焦×动态美学 |
| 通道三 | 光场:多重曝光半透明叠加×过曝+暗调分层×侧光 |
| 关键对抗 | 日常快照(摄影行为层) × 超现实主义(视觉内容层) 分频共存 |
FAQ
三重采样和上一次的风格分频有什么区别?
风格分频处理的是三种画风(莫奈/梵高/伦勃朗)在同一画面的共存——画风是抽象的”视觉频率”。三重采样处理的是三台虚拟相机同时按快门——每台相机的参数(广角/慢快门/多重曝光)产生的是明确可定位的视觉信号。分频解决”怎样不互染”,采样解决”怎样同时触发”。
这三组摄影参数在 Stable Diffusion 里能复现吗?
SD 系列对摄影术语的理解深度和 Seedream 5.0 系列有差异。多重曝光叠加在 SD 中通常需要 ControlNet 辅助或分步生成后合成,而不是单次 Prompt 触发。慢快门效果在 SD 中较易表现,超广角空间压缩则取决于模型对焦距词的理解。建议用 Seedream 5.0 直接用原文 Prompt,SD 用户可拆成三次生成后合成。
这条 Prompt 会不会触发内容审核?
Prompt 中的词汇为摄影术语和视觉风格描述,「妖冶」「魅惑」等词汇在 Seedream API 中属于风格形容而非违规内容——API 将其归类为”暧昧气质”风格标签而非敏感词。实际调用中直接用原文即可通过。
评论0