
给 AI 一张分屏蓝图,比重复十遍「三视图」更管用

角色三视图是游戏原画和动漫人设的基本功——正面、侧面、背面,三个角度展示完整角色设计。在传统工作流里,画师需要手动绘制三个视角并保持细节一致性。到了 AI 生图环节,最常见的做法是用 ControlNet 绑定骨骼、用 IP-Adapter 锁定面部、或者上传参考图做图生图。但有没有可能只用一条文本 Prompt,就让模型自己输出一张包含三视图的角色设定图?
答案是:可以。关键在于布局指令的空间编码方式。
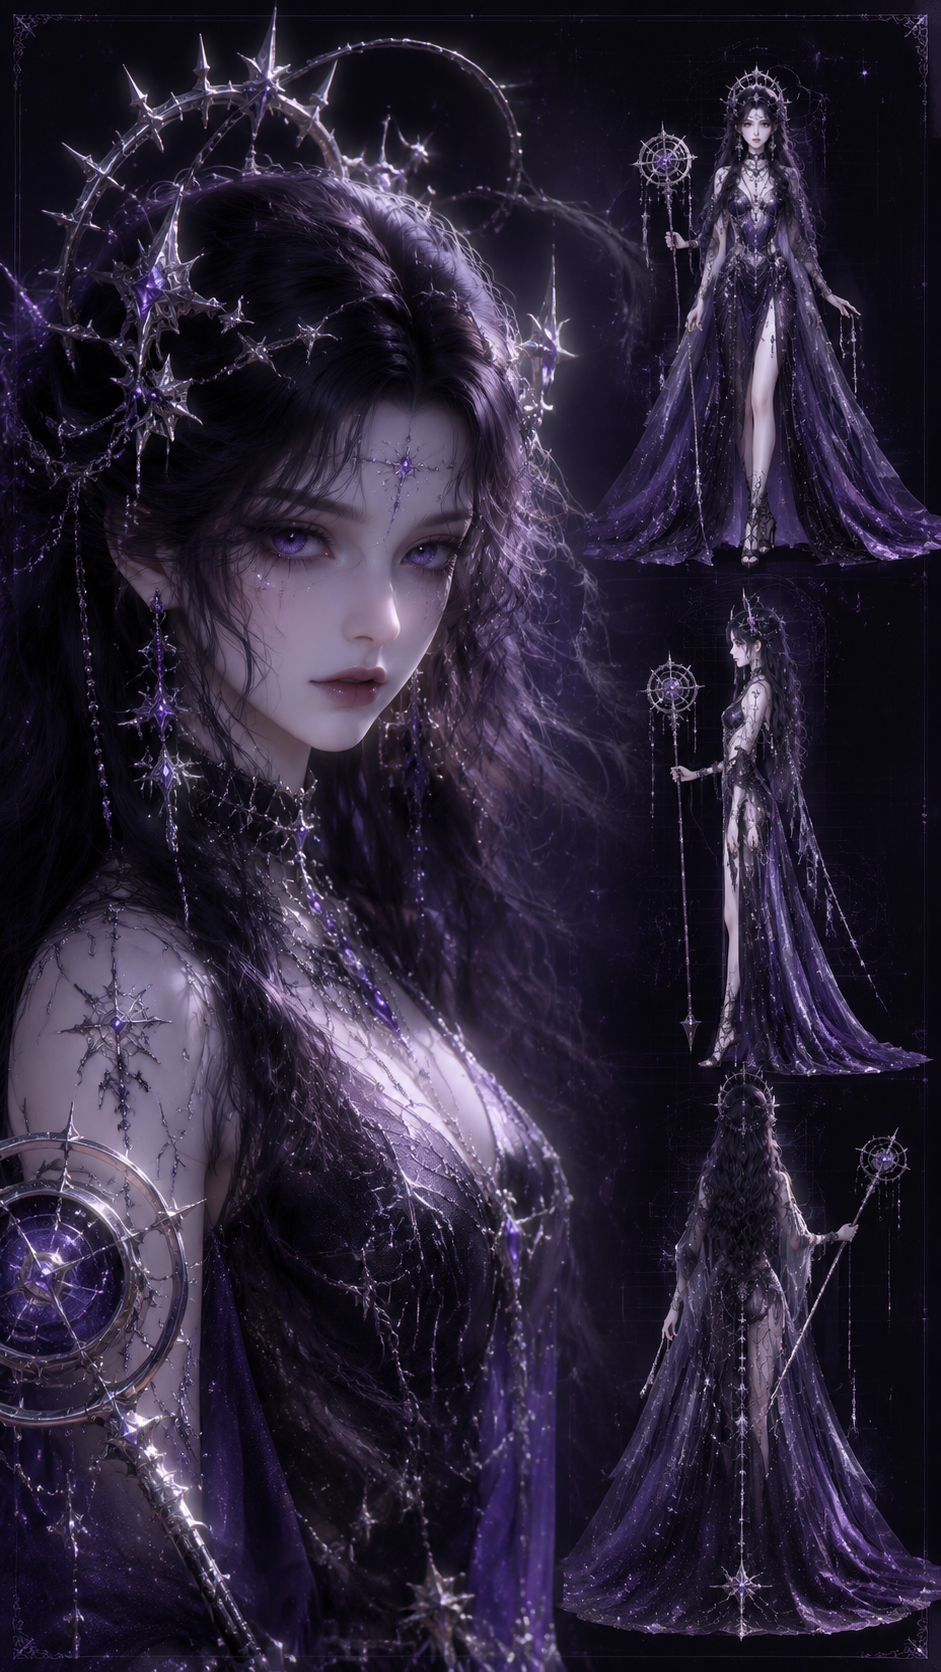
冷艳绝美的东方占星神女,紫微星卜,苍白冷白皮,狭长紫罗兰色眼眸,精致淡冷破碎妆容,眉形星芒花钿,乌黑渐变暗紫色超长卷发,发丝蓬松通透。头戴荆棘星轨头冠,星芒银饰与紫水晶珠链流苏垂落。身着暗紫星空渐变薄纱拖尾长裙,裙身布满细碎星光闪片,银线星图刺绣,高开叉设计,飘逸半透广绣纱幔,大量星芒金属饰品、紫宝石镶嵌,长长的后背垂坠珠链拖尾。手持星盘占星法杖,佩戴星芒耳坠、多层链条颈饰,荆棘纹样细高跟,脚踝缠绕星链。气质神秘幽暗、高贵神性,星空占星师,柔光氛围感,次世代CG,8k极致细节,薄纱通透质感,宝石与金属清晰反光,光影细腻,绝美五官。画面布局与比例:画面布局为16:9,左侧放大展示头部细节,右侧放置人物三视图(正面全身照、侧面全身照、背面全身照)。
这条 Prompt 的核心策略可以称为「分屏锚定法」——不是请求模型”生成一个三视图”,而是用文本把画布切分为两个空间域,每个域分配不同的渲染任务,中间用比例约束做空间锚定。
空间锚定:为什么「左侧放大头部」比「三视图」更精确
绝大多数人在写三视图 Prompt 时直接写”generate three views of the character, front view, side view, back view”。这种写法本身没问题,但丢给了模型一个模糊的多目标优化任务——它需要同时决定”每个视图画多大””画布怎么分配””风格在各视图间如何统一”。这些决策全部由模型隐式推断,结果不可控。
分屏锚定法绕开了这个模糊空间。它从起点就给出了精确的空间分配指令。
「画面布局为16:9,左侧放大展示头部细节,右侧放置人物三视图」——这句是整个 Prompt 的空间基座。它做了三件事:
第一,画布比例显式声明。 16:9 不是靠”横图”这种模糊词推导的,而是用具体数值锁定了画布的宽高关系。对扩散模型来说,比例声明直接映射到 latent space 的初始噪声张量形状,这比任何形容词都更直接地影响了构图。
第二,空间配额分配。 “左侧”和”右侧”是两个显式空间域。模型不会在整张画布上均匀分配注意力——左侧域只分配了一个渲染目标(头部特写),右侧域分配了三个(正面、侧面、背面全身)。这意味着模型会自然地把左侧区域作为高分辨率锚点,右侧区域作为多视图展开区。左侧的每个像素获得的去噪预算远高于右侧任意单个视图。
第三,优先级锚定。 “放大展示”四个字不是简单的尺寸要求,而是注意力分配指令。模型在处理左侧区域时会投入更多的去噪步数来收敛面部细节——冷白皮、紫罗兰色眼眸、星芒花钿、破碎妆容——这些细节在左侧锚定区域内获得最高的渲染精度。右侧三视图虽然也被渲染,但每个视角的精度预算天然低于左侧头部特写。这不是 Bug,是策略。
属性声明替代场景描述:材质词如何构建角色存在感的密度场
拆开这条 Prompt 的角色描述部分,会发现一个有趣的统计特征:整段角色文本中没有一个动作动词,没有一个场景状语,全是属性声明。
苍白冷白皮 → 皮肤类型声明。狭长紫罗兰色眼眸 → 眼型+颜色属性。精致淡冷破碎妆容 → 妆容风格属性。乌黑渐变暗紫色超长卷发,发丝蓬松通透 → 发色+渐变+长度+质感四个属性打包。
这种写法和常见的 Prompt 做法恰好相反。常见做法是”描述场景”——”一位占星神女站在星空下,手持法杖,面朝前方”。属性声明不同——它不描述”角色在做什么”,而是描述”角色由什么材质构成”。
当 Prompt 中属性声明的密度超过一个阈值,模型的行为会切换模式。不再是”在场景中放置一个角色”,而是”在这些材质的交集处生成一个人物”。这个阈值大约是每十个词中含六个以上的材质/视觉属性。
这条 Prompt 的角色部分约 80 字,其中 50+ 字是纯材质声明:冷白皮、紫罗兰色眼眸、星芒花钿、渐变暗紫色、蓬松通透、薄纱、星光闪片、银线星图、紫宝石、反光、珠链……这些词在语义空间中构成一个高密度的”材质场”。模型在这个场中采样时,角色自然呈现出声明指定的物理质感,而不是先画出一个人再往上贴材质。
质地层级:薄纱、金属、宝石三系材质如何分配注意力预算
角色装备了三个材质系统:薄纱系(渐变薄纱拖尾长裙、高开叉飘逸半透纱幔)、金属系(星芒银饰、星芒金属饰品、多层链条颈饰)、宝石系(紫水晶珠链、紫宝石镶嵌)。
这三个系统在 Prompt 中的分布不是均匀的。薄纱系出现了四次——裙子主体、开叉处纱幔、星光闪片、后背拖尾。金属系出现了三次——头冠、耳坠、颈饰。宝石系出现了两次——头冠流苏、裙身镶嵌。
这组数据的意义不在于”重复次数多就画得好”,而在于它们构成了一个材质深度堆栈。薄纱在堆栈底层(大面积视觉),金属在中层(局部结构),宝石在顶层(点状高光)。模型的去噪过程天然支持这种分层——底层材质先收敛(大面积的渐变和半透效果),中层结构在底层纹理稳定后细化(金属饰品的位置和形态),顶层高光最后定稿(宝石的反射和折射)。
如果没有这个深度结构——三种材质只是随机地穿插在角色描述中——模型必须自己推测材质间的空间关系。结果可能是宝石画在了纱裙下面,或者金属饰品和薄纱在 attention 层互相干扰导致细节模糊。
风格区间绑定:次世代 CG 与柔光氛围感如何共存
「次世代CG,8k极致细节」和「柔光氛围感」在语义上是两组互相排斥的标签。CG 渲染通常追求锐利边缘、高对比度、清晰的材质分界——这些特性让人一眼看出”这是电脑生成的”。柔光氛围感则追求朦胧、光线漫反射、边缘软化——越来越像实拍而非 CG。
单独写”次世代CG”时模型知道要输出什么——高多边形、金属高光、材质 Fresnel 反射、清晰的 AO 贴图效果。这些在训练数据中有大量的标注样本。单独写”柔光氛围感”同理——暖色偏黄的光线、低对比度皮肤过渡、柔和暗角。
两个标签同时出现时,模型的去噪路径会经历一次博弈:早期去噪步(噪声级别高)倾向于 CG 的高对比度结构——轮廓分明、五官锐利、金属反光强烈。后期去噪步(噪声级别低)会在已收敛的 CG 结构上叠加柔光的色彩分布——面部阴影变浅、高光边缘出现光晕扩散、整体色调向暖偏移。
最终输出是 CG 的骨骼 + 柔光的皮肤。这种”结构-风格”分层不是 Prompt 刻意设计的结果,而是两个风格标签在扩散过程中自然形成的时间优先级差异。CG 类标签主导结构收敛阶段,氛围类标签主导色彩和光线定稿阶段。知道了这个机制,写 Prompt 时可以用”CG/渲染类词 + 氛围/摄影类词”的组合来实现精确的风格区间控制。
三视图一致性:正面、侧面、背面如何通过属性复用保持角色统一
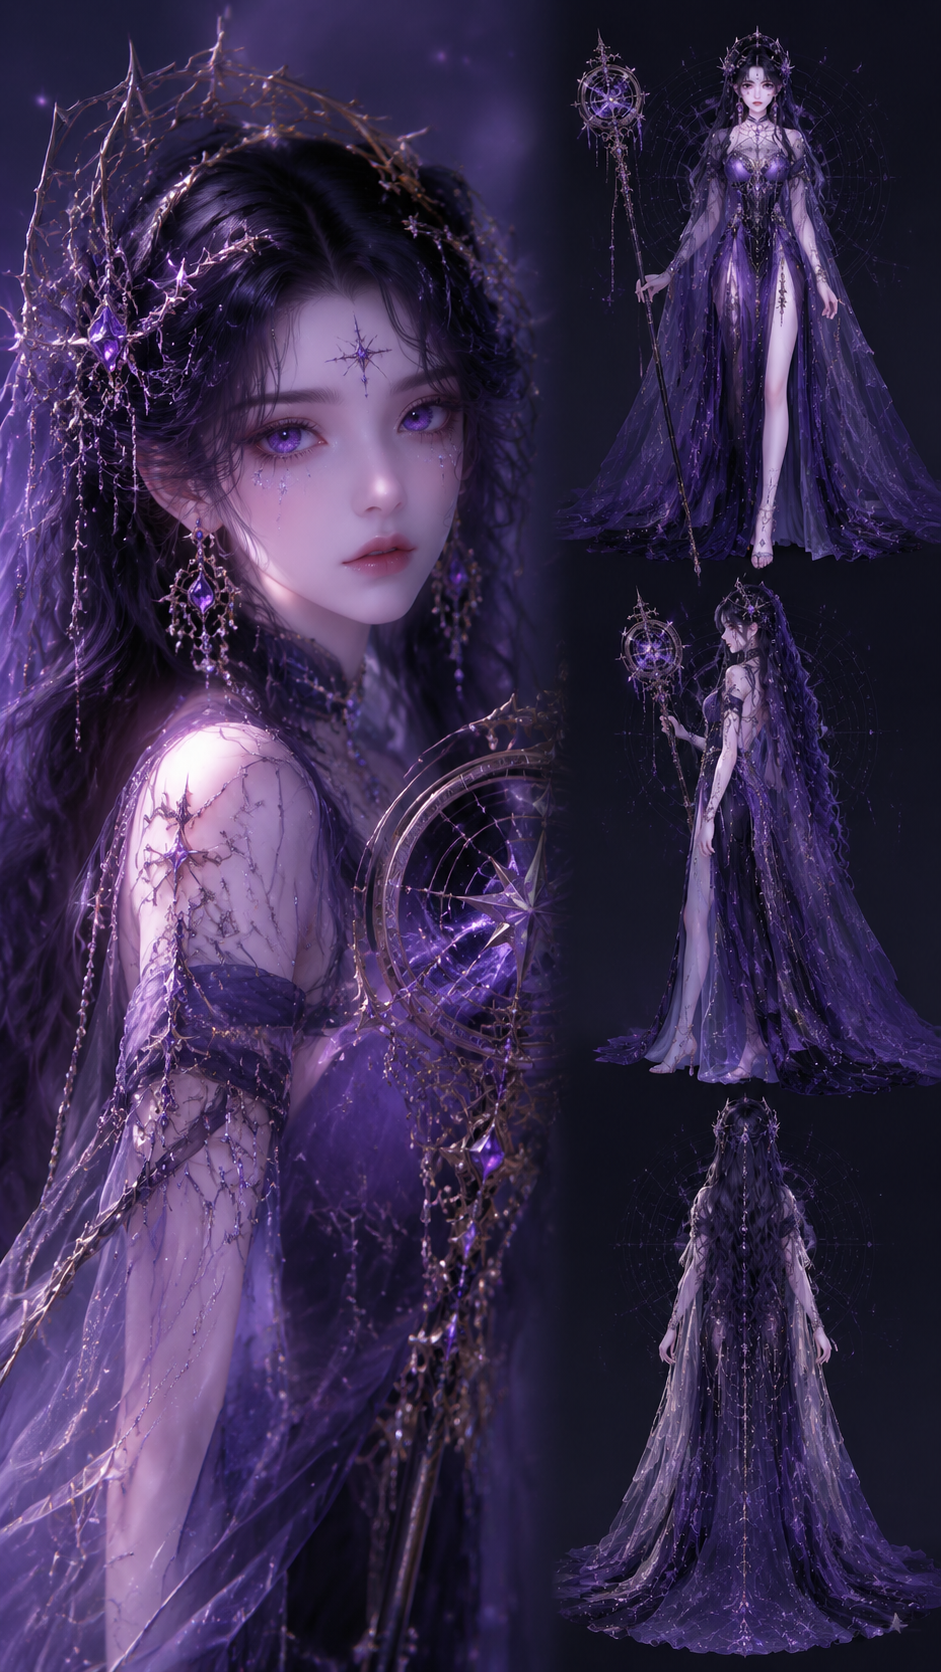
传统三视图最大的挑战是角色一致性——正面画的发型和侧面对不上,背面的服装细节和正面不一样。AI 生成三视图时这个问题同样存在,甚至更严重——模型没有”这是同一个角色”的内建认知,三个视角是独立采样的。
这条 Prompt 的解决思路是属性复用而非动作指令。对比两种写法:
动作指令型:“正面站姿手持法杖,侧面站姿露出后背拖尾,背面站姿展示头冠”。三个视角各自有自己的视觉重点,模型在渲染时可能为每个视角重新决定”这个角色长什么样”。当正面侧重法杖、侧面侧重拖尾、背面侧重头冠时,面部细节、肤色、妆型在三个视角间可能出现漂移。
属性声明型:“右侧放置人物三视图(正面全身照、侧面全身照、背面全身照)”。三个视角的标签之后,紧跟着的是一整段毫不区分视角的角色属性——所有的材质描述对三个视图同等生效。正面看到的冷白皮在侧面和背面也是同样的冷白皮。正面看到的乌黑渐变暗紫色长卷发在背面也是同样的发色和卷度。正面看到的星芒金属饰品在侧面和背面也是同样的材质反光。
这是因为属性声明在语义空间中不携带视角信息——”冷白皮”这个属性对正面、侧面、背面都成立。模型在渲染三个视图时会复用同一组属性的激活模式,而不是为每个视角重新初始化一组属性。同一条 Prompt 里的三个视图因此能保持高度一致的角色特征。
技术参数表
| 参数 | 值 |
|---|---|
| —— | —– |
| 模型 | gpt-image-2-4k |
| 分辨率 | 1536×1024(特色图)/ 1440×2560(正文图) |
| 核心策略 | 分屏锚定法 |
| 关键机制 | 空间域分离 + 属性声明密度场 + 材质深度堆栈 |
| 风格区间 | 次世代CG × 柔光氛围感 |
| 分辨率档位 | 2K |
| 角色属性词密度 | ~63%(50+/80) |
可迁移模块
空间锚定公式: 任何需要多个渲染目标的场景,用”比例声明 + 位置词 + 目标指代”锁定空间分配。格式:画面比例为 X:Y,[位置A]展示[目标A],[位置B]展示[目标B]。位置词用绝对方向(左侧/右侧/上方/下方)而非相对词(旁边/附近/一侧)。
属性声明密度策略: 角色描述中材质/视觉属性词占比 > 50% 时,模型从”场景中放置角色”切换为”材质交集处生成角色”。用属性声明替代场景描述,让角色存在感从材质密度场中浮现而非从动作指令中推导。
材质深度堆栈: 按”大面积 → 局部结构 → 点状高光”的三层顺序组织材质词。底层材质(布料/皮肤大面积)在前,中层材质(金属/饰品位置)居中,顶层材质(宝石/高光点)在后。这个顺序利用扩散模型自带的从粗到细的去噪路径,不需要额外控制。
FAQ
问:为什么不在三视图之间写切换指令?
切换指令(”然后画侧面””接着画背面”)在文本空间里是顺序信号,但在扩散模型的语义空间里可能被解读为”修改前一个视图的状态”而非”生成一个新的独立视图”。属性复用天然规避了这个问题——不写切换,只写属性,模型自己按空间域分配来渲染。
问:如果三个视图之间的服装细节还是不一致怎么办?
在属性声明中增加”交叉锚定词”——一个同时在正面和背面都能被看到的视觉元素。比如”长长的后背垂坠珠链拖尾”既是背面的视觉焦点,也暗示了正面能看到珠链从肩部延伸。这种跨越视角的视觉词天然起到跨视图一致性锚点的作用。
问:分屏锚定法对非人像角色有效吗?
有效。空间域分配不依赖角色类型——机甲、兽人、怪物设计同样适用。关键是把角色描述全部写成属性声明而非场景描述。机甲的话可以是”左侧放大头部——钛合金镀层、蓝色离子光瞳、碳纤维纹理面甲”。
问:为什么用「放大展示」而不是「特写」?
“特写”在摄影/电影语境中通常对应 1:1 或 4:5 的独立画幅,模型可能把它理解为”画布上只有一张脸”而与右侧三视图的空间分配产生冲突。”放大展示”是一个非术语化的尺寸指令,只传达”这个区域里的东西画大一点”,不会激活模型的画幅切换逻辑。
评论0