
拍 AI 时尚大片的难度,和实拍没有本质区别。实拍要找摄影师、模特、棚、灯光师、造型师。AI 生成也要在 Prompt 里依次解决这几个问题。
主流做法是把场景描述塞进一句通顺的自然语言。”一位穿着黑色紧身衣的模特在白色摄影棚里摆出优雅姿势,柔和灯光……”
这句话本身没问题,但这是一句话,不是一组参数。
当一条 Prompt 把所有信息压缩进一个叙事流时,模型的注意力机制会做优先级排序——某些元素被弱化,某些被强推。灯光描述被构图盖过,姿态描述被服装质感盖过。
有没有办法让所有元素都得到平等的注意力分配?
有。不写场景叙事,分成三个独立的参数域并行声明。
Prompt 原文
9:16 竖构图,逼真奢华时尚摄影编辑风格,无缝暖白色摄影棚背景,柔和漫射胶片照明,高调曝光,奶油色高光,细微晕影,柔和绽放,柔雾效果,细腻 35mm 胶片颗粒,温暖象牙色调级,高端杂志摄影。
一位美丽的成年东亚时尚模特,明顯為成人,皮膚白皙發光,自然妝容,深色頭髮鬆散地紮在腦後,神情平靜。
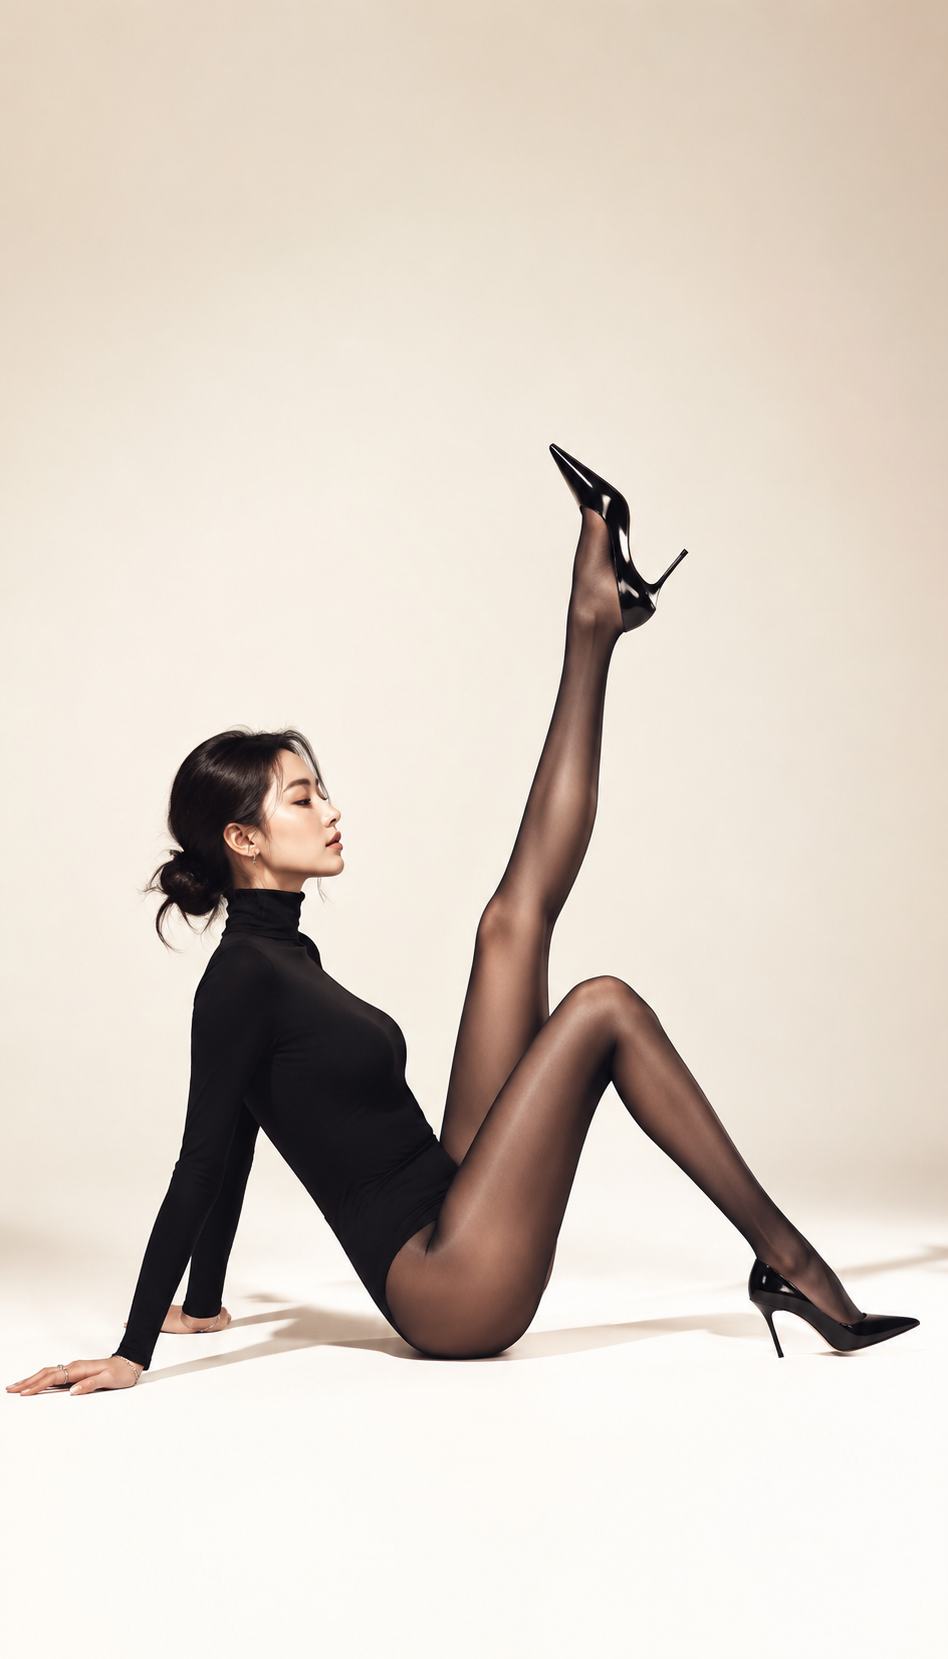
她在攝影棚地板上表演雕塑般的編輯姿勢,從側面觀看。一條腿向上伸展,另一條腿自然交叉,創造優雅的幾何線條和平衡的構圖。放鬆的雙手自然支撐姿勢。逼真解剖結構,優雅比例。
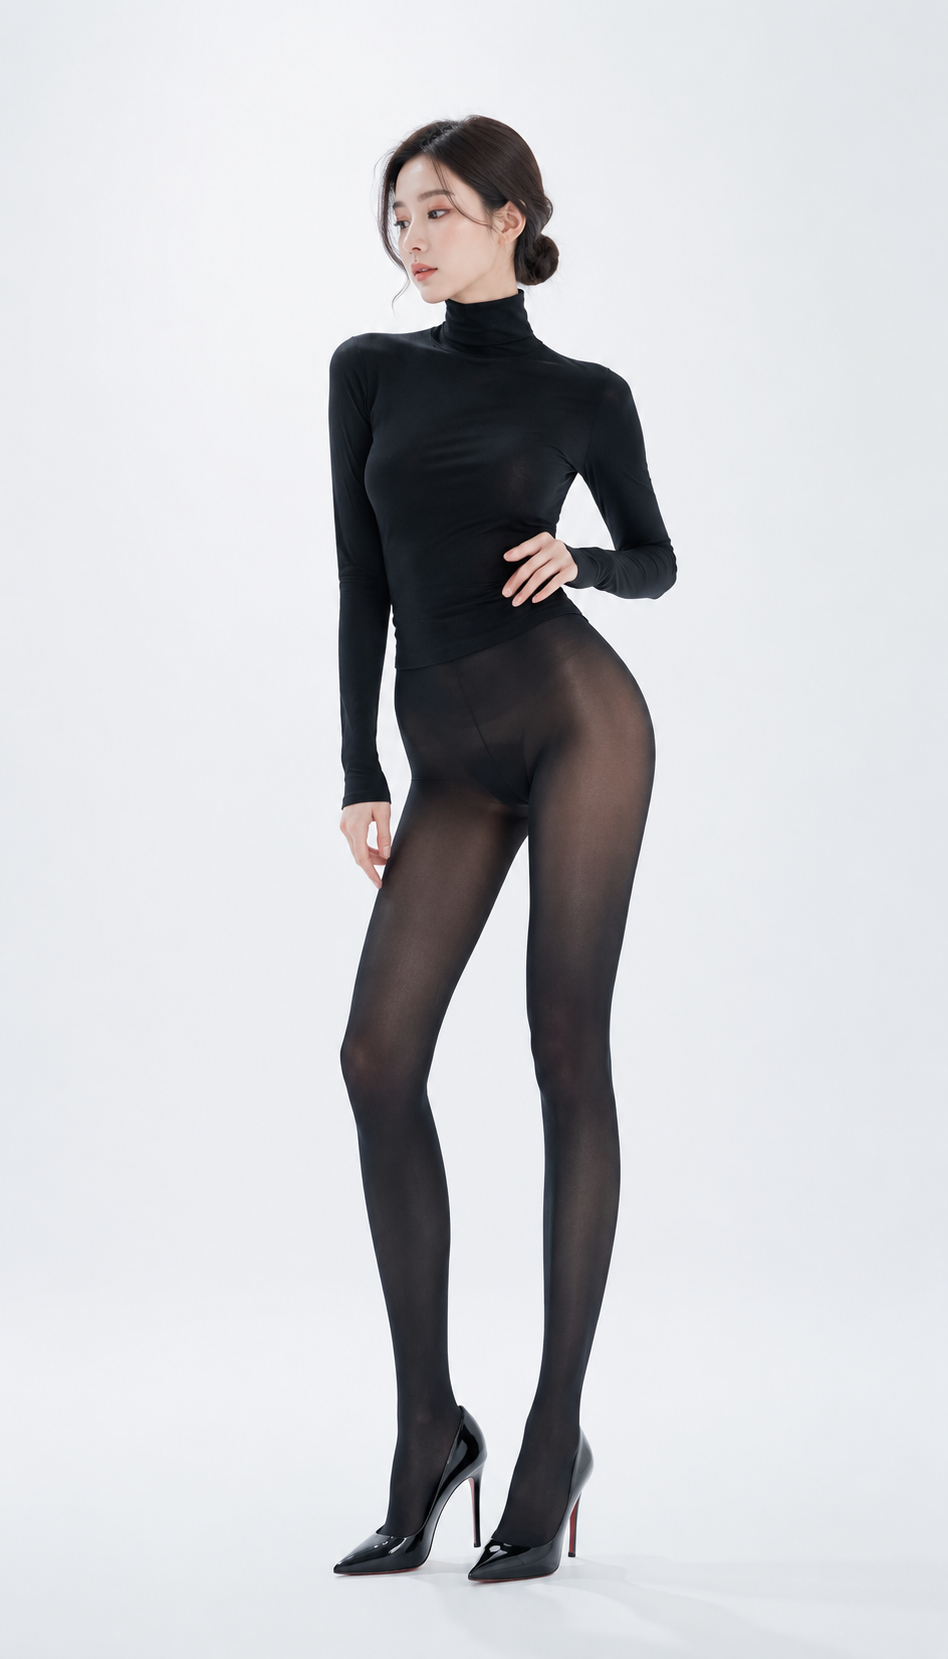
服裝:合身黑色高領緊身體衣,半透明黑色緊身褲,光澤黑色尖頭高跟鞋,極簡銀色珠寶。
極簡構圖,全身拍攝,寬裕負空間,精緻時尚廣告活動,優雅造型,超逼真。
这个策略可以称为「三域编码法」——将 Prompt 拆为摄影工艺域、人体姿态域、造型构图域三个独立区块,每个区块自含完整参数,区块间不交叉引用。
域一:摄影工艺域
第一段没有任何”人”的信息位。全是灯光、色调、质感。
这个设计反直觉:最重要的信息先于主体出现。模型读到第一段时,已经在潜意识里建立了”这是一个高端棚拍场景”的框架基调。
“无缝暖白色摄影棚背景”定义了空间基础——一个没有接缝、无限延伸的白色场域。”柔和漫射胶片照明”和”高调曝光”是一对:漫射光消除硬阴影,高调曝光把整体亮度推高,直接导向”奶油色高光”——高光区域不是死白,是有质感的奶油色。
“温和晕影”和”柔和绽放”画龙点睛。晕影让画面四角微微变暗,在视觉心理上暗示”昂贵杂志”——广告大片常用暗角让视线聚焦中心。绽放效果引入了小幅耀斑溢出,模拟真实棚拍中大光圈镜头的物理特性。
35mm 胶片颗粒是另一个关键参数。在超高解析度的 AI 生成图里,追求”干净”反而是陷阱——太锐利、太完美,一眼 AI。微弱的胶片颗粒提供了一个天然的”质感框架”,让画面落入真实摄影的视觉范畴。
域二:人体姿态域
第二段和第三段合并处理姿态。编排策略是外观描述在前,姿态指令在后,以”神情平靜”做过渡节点。
“成年东亚时尚模特”和”明顯為成人”重复强调了年龄属性。这种冗余在 AI 语境下不是废话——模型生成人物时,成人特征(骨骼结构、皮肤纹理、面部比例)经常被”无龄化”倾向拉偏,两条确认让模型不产生歧义。
姿态描述最精彩的部分在几何化表达。”一條腿向上伸展,另一條腿自然交叉”——这不是口语化的”她抬了抬腿”,而是一组由方向和关系构成的空间运算指令。”放鬆的雙手自然支撐姿勢”交代了手的位置,但不指定细节。
关键节点锁定,非关键节点留白,是人体域的设计原则。
域三:造型构图域
第四段和第五段合并处理。”服裝:”前置冒号是一个明确的列表声明句式——不写”她穿着……”,直接列出物品清单。
这种结构的优势:扩散模型处理列表的注意力分配,比处理自然语句更均匀。”合身黑色高領緊身體衣,半透明黑色緊身褲,光泽黑色尖头高跟鞋,极简银色珠宝”——四个物品平权级并行,没有一个被语法结构推向从属地位。
半透明紧身裤是一个细腻的选择。全遮盖紧身体衣是高反光材质,半透明紧身裤在视觉上做出减法——让一部分腿部肌肤的质感透出来,打破全黑造型可能导致的沉闷感。
第五段用四个短语收束:极简构图、全身拍摄、宽裕负空间、超逼真。”宽裕负空间”是最容易被忽略但最有价值的指令。负空间在摄影美学中直接关联”高级感”——留白越多,画面越接近杂志广告的视觉密度。
三域机制为何有效
三条域比一条叙事句更有效,不在于信息量更多,而在于注意力分配的粒度不同。
模型处理”一位穿着黑色紧身衣的模特在白色背景前摆出优雅姿势,柔和灯光……”时,注意力机制对句子做依存分析——”模特”是主语,”白色背景”是地点状语,”柔和灯光”是伴随状态。主谓宾结构天然给主体词汇更高的注意力权重。
三域编码法的每一条域都是独立声明句群。模型对第一条域的注意力分配不会因为第二条域的出现而被稀释——它们在时序上是独立的注意力窗口。
利用 Prompt 的结构顺序,强制模型维持对每个维度的平等关注。
技术参数表
| 参数 | 取值 |
|---|---|
| 框架名 | 三域编码法 |
| 域数量 | 3(摄影工艺 / 人体姿态 / 造型构图) |
| 总词数 | 约 280 词(中文) |
| 核心策略 | 参数域平行声明替代场景叙事 |
| 适用模型 | Seedream / DALL·E 3 / Midjourney / Flux 等 |
| 适用场景 | 时尚大片 / 产品广告 / 人像写真 |
| 特色技术 | 多层胶片颗粒模拟 / 几何化姿态描述 / 负空间声明 / 物品列表平权化 |
可迁移模块
摄影工艺域模板
替换第一段的核心配方:[背景] + [照明类型] + [曝光策略] + [高光处理] + [特殊效果] + [质感声明]。换掉”棚拍”,照明换成”硬光”/”侧光”/”顶光”,”胶片颗粒”换成”高清晰度”/”扫描仪质感”,就能用于摄影棚之外的场景。
列表声明句式模板
“服裝:”前置冒号的列表声明可迁移到任何需要物品描述的段落——”道具:”、”配飾:”、”妝容:”。核心价值在于实现物品平权,不让任何一个物品在语法中沦为修饰成分。
几何化姿态描述模板
“一條腿向上伸展,另一條腿自然交叉”的模式本质是不描述”形态”,描述”关系”。通用公式:[部位A][方向动作],[部位B][对应动作],創造[几何特征]和[视觉效应]。替换动词和部位数组,即可生成任意姿态指令。
FAQ
Q:这条 Prompt 是否适用于 1:1 或 3:2 比例?
A:适用。把开头的”9:16 竖构图”换成目标比例即可。比例变化会影响负空间效果——越宽幅,负空间越需要主动管理。
Q:三域之间的顺序是否可以调换?
A:可以但会影响结果。摄影工艺域放在首段效果最稳定,因为它先于主体建立了场景基调。姿态域前置可能导致模型轻背景重人物,产生”人物素材叠加”而非”场景内嵌人物”的效果。
Q:是否需要为每张图单独微调 Prompt?
A:不需要。这条 Prompt 自含性强,在同等分辨率和质量参数下,多次生成的一致性表现稳定。模型换用(如从 Seedream 切到 Flux)时可能需要微调,不同写实模型的光化学感不一样。
评论0