
Hook:角色重塑类 Prompt 的常见误区
一条角色重塑 Prompt 最容易犯的错误是什么?是写得过多。
角色名穿上身、武器持在手、服装细节逐行列、场景氛围铺满整段——好像告诉模型越多细节,它就越能还原角色。但实际效果恰恰相反。细节堆砌的图,第一眼就让人感受到「这是一张经过精密调配的合成照」,而非角色本身的在场感。技术精度和角色气质之间,存在一道越写越远的鸿沟。
这种困境的解法不在添加,而在控制。
在角色创作者圈子中流传着一段英文分析帖,讲的是为什么某些角色还原图能让人一眼停住,读完之后会发现,它说的根本不是如何描述服装,而是如何驾驭视觉结构。
A truly high-level character recreation is never just about getting the costume right.
What makes it powerful is that, at first glance, you can already feel the character’s aura, silhouette language, and color logic fully established.
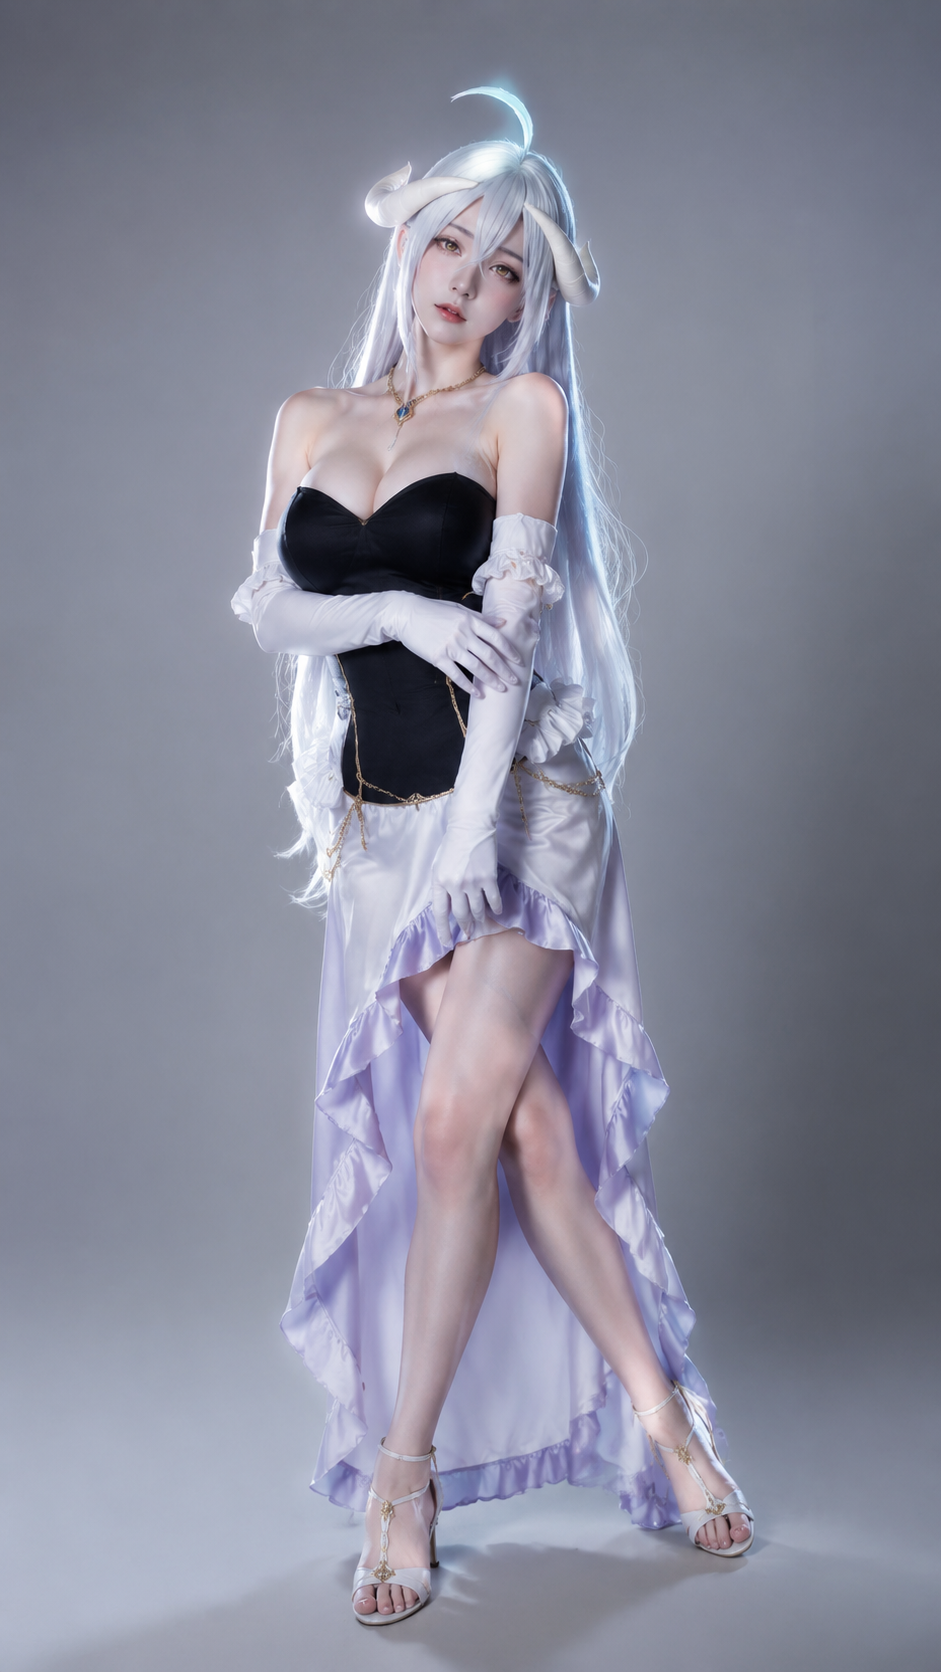
The smartest part of this image is its restraint. It doesn’t rely on a busy background. Instead, the clean gray space gives all visual attention back to the character.
The silver-white hair, pale skin, white-and-purple palette, flowing sleeves, and layered skirt create a highly unified visual structure.
It wins not through excess, but through control, rhythm, and presence.
From an artist’s perspective, the strongest part is not “sexiness.” It is restrained elegance.
The slight tilt of the body, the crossing balance of the legs, and the vertical fall of the sleeves all work together to support both the softness of the figure and the richness of the costume design.
Memorable character work is never about adding more elements. It is about making every detail serve the presence of the character.
This doesn’t feel like someone simply wearing a costume. It feels like the soul of a 2D character has been repainted through real-world texture.
Pure, delicate, fragile, yet quietly noble.
That is why strong visuals make you stop at first glance — and then pull you back in to admire the details again.
这段分析揭露了角色还原类 Prompt 的一个核心矛盾:模型不需要被告知「角色穿什么」,它需要被引导去「感受角色在场」。
这个策略可以称为「气场锚定法」——先建立视觉场,再让角色从场中自然浮现。
轮廓语言先行,服装描述后置
大多数 Prompt 在角色部分做的第一件事是声明服装。「身穿黑色西装」「白色连衣裙」「铠甲全身覆盖」——这是典型的出厂设定写法。但模型对角色身份的判断,首先来自轮廓,而非纹理。
气场锚定法的第一条规则是:先写剪影,再填空。
银白色长发垂坠于肩颈两侧,形成宽阔的横向轮廓。修长的颈部与锁骨区域形成上半身的视觉重心。双臂自然垂放时袖管的下坠走向勾勒出身体的中轴线。裙身材质的纵向垂感延伸了形体线。
这些声明全是在描述结构关系,而非面料细节。模型读到这些词时,注意力分配到了形体比例和姿态动线上,而非花哨的纹理贴图。等轮廓稳定之后,再加入黑白紫色调、丝绸质感、分层裙摆等细节声明,模型才有足够的上下文空间去正确解析。这不是一个顺序问题,而是一个权重分配问题。轮廓声明在前,相当于为主体的视觉结构锁定了一组关键帧,后续的所有细节声明在同一套结构框架内解码,信息冲突的概率大幅降低。
色彩区间控制比单色声明更可靠
Prompt 中直接用「白色和紫色」声明角色配色时,模型经常偏离预期——白偏黄、紫偏粉、两种颜色相互渗透的边缘变得模糊。
气场锚定法采用区间控制而非单点声明:不写「白色和紫色」,而写「白紫混合色调,白的区域集中在发丝与丝绸高光处,紫的区域集中在裙摆阴影与衣袖内衬,两色之间用冷灰过渡」。这种声明方式利用了模型的注意力分布特性——当两种颜色被赋予空间归属(什么区域是白、什么区域是紫、哪里是过渡),模型会在像素层面自然解码出更精确的色块边界。
关键诀窍是提供一个中间色(冷灰/银灰)。没有过渡色时,模型倾向于用模糊或花纹来弥合断裂的色块。有了中间色,解码路径变成:白→冷灰→紫。三种颜色构成一个稳定的视觉色阶,而非两种颜色的碰撞。
克制声明替代清单式要求
气场锚定法的第三层是元声明——不是描述角色有什么,而是描述角色图像应该让观众感受到什么。这与主流 Prompt 写法截然相反。通常的做法是「添加更多限定词来缩小模型的出图范围」。气场锚定法反其道:用克制声明来放大模型的自主填充空间。「最能体现这条 Prompt 智慧之处在于它的克制」——引导模型不要过度填充。干净的背景把视觉注意力还给主体,不靠背景元素堆砌氛围。从模型行为角度看,当背景声明被压缩到极致(单色/干净/留白),模型的注意力权重会从环境解码回撤至主体解码。这意味着脸部、头发、服装细节获得更高的像素分配比例。放弃背景控制,就是主动让出计算资源给角色本身。
很多角色还原图加了详尽背景声明后,主体反而崩了——模型把解码能力分散到了背景中每一件物体上。
动态平衡声明铺陈角色的”在场感”
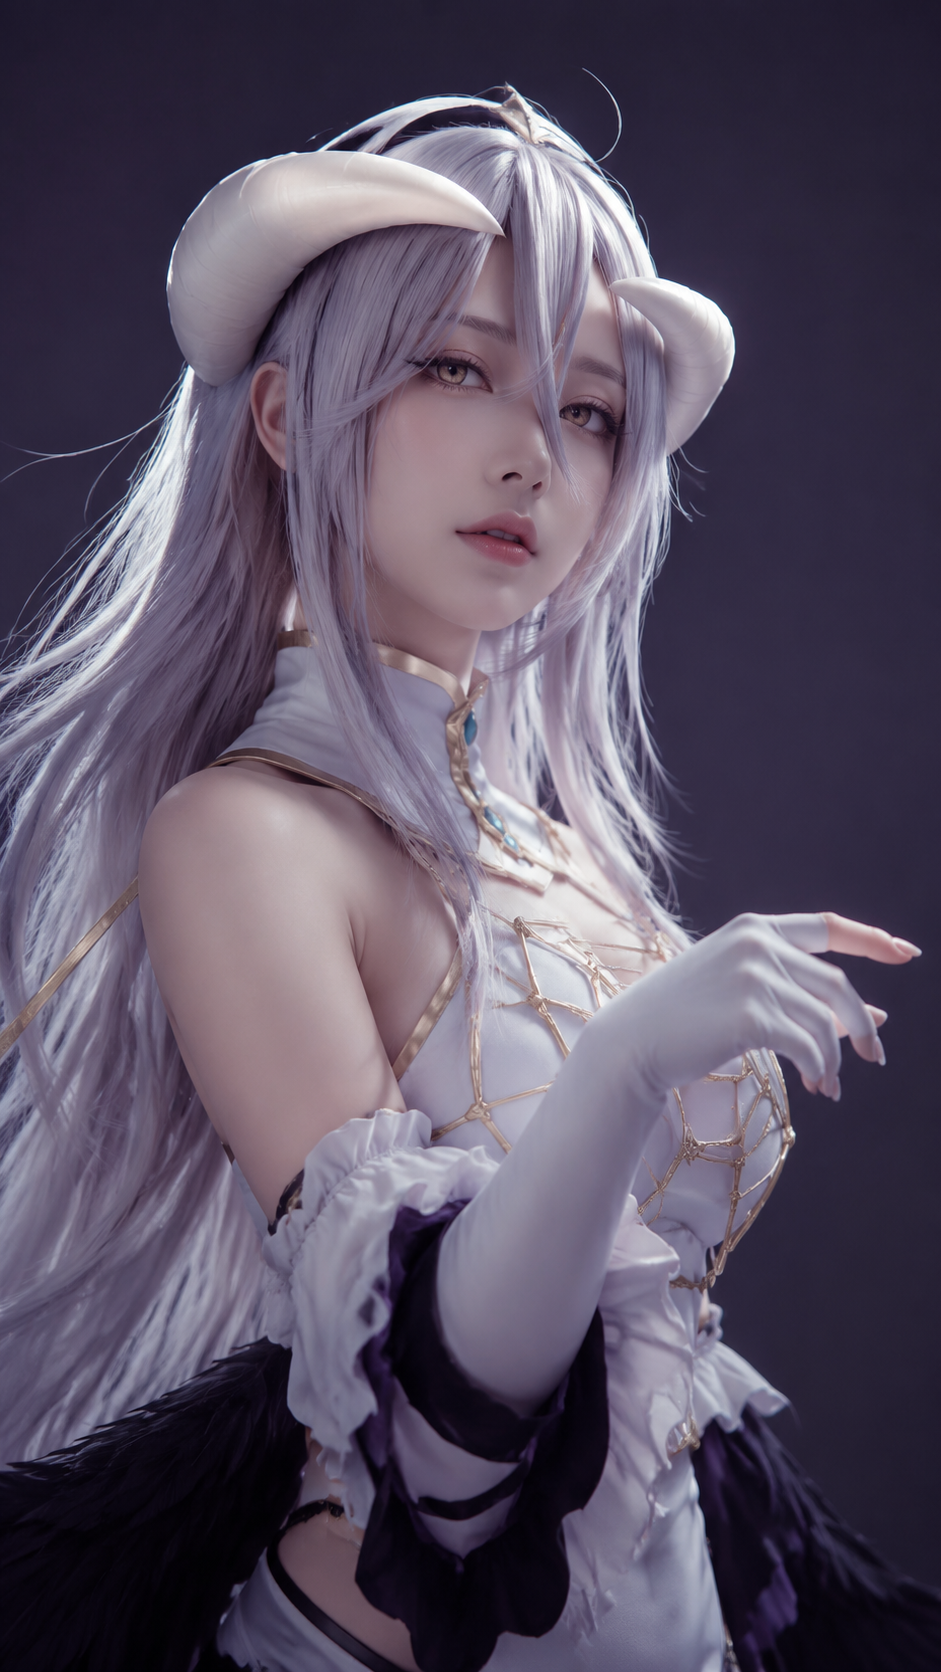
角色还原的最高评价不是「像」,而是「在场」。观众感觉角色正在阅读那个空间,而不仅仅是出现在那张图上。
气场锚定法在 Prompt 末尾使用一段韵律化声明来锚定在场感。这类声明不描述具体属性,而是定义一个感受区间:纯粹、细腻、脆弱却又高贵。
这种矛盾修辞(fragile yet noble)是有意为之。矛盾修辞的作用经常被低估——它给模型开放了一组参数空间:两端之间的张力驱动了更丰富的表情解码。纯粹中带细腻不是中性中立,而是温和的暖;脆弱中带高贵不是柔软无骨,而是有弹性地挺立。
模型在处理这种矛盾声明时,不会去平均两个词的语义,而是试图在图像中同时呈现两种特质。结果是角色的表情和姿态拥有了更丰富的层次——既不是完美无缺的冷峻,也不是完全柔软的无害。
这个效果在角色姿态声明上同样成立。微侧的身姿、交叉的双腿、宽大袖管的垂直坠落——三组矛盾的静态描述构成一个完整的重力锚点。所谓在场感,就是这种重力锚点引发的物理存在联想。观众看到一张图,下意识判断画面中的人物是「站在那里」而非「被贴在上面」,区别就在于这些姿态声明是否具备物理可信度。轮廓语言解决的是「像」,姿态的物理可信度解决的是「在」。两者叠加,模型输出的角色才有了呼吸间隔。
气场锚定法可迁移的关键
这个框架不只适用于角色类 Prompt。它的控制逻辑——先建立结构再填充细节、区间控制替代单点声明、克制声明放大模型自主空间——可以迁移到任何需要视觉统一性的场景。
对角色设计场景,可以用短语锚固色彩区间与轮廓指引,而非使用详细的身体描述。色彩区间的写法对多角色场景同样有效——给每个角色分配一组主色调+过渡色+辅助色,模型在解码多角色构图时,色块的归属度会显著高于用「XX穿着红色、XX穿着蓝色」的并列描述。对道具生成场景,限制背景解码空间可让模型集中资源于主体特征。对叙事性角色图片,矛盾修辞技法可在极短 Prompt 内驱动丰富的情绪层次。
技术参数表
| 参数 | 推荐值 | 说明 |
|---|---|---|
| 模型 | gpt-image-2 / Seedream 5.0 | 长 Prompt 处理能力强,色彩解码准确 |
| 尺寸 | 1536×1024(特色图) | 3:2 横版,封面推荐 |
| 尺寸 | 1440×2560(正文图) | 9:16 竖版,移动端适配 |
| 角色声明密度 | ≤5 个属性的篇幅 | 超过后边际收益递减 |
| 背景声明 | 1-2 个词(”干净灰空间”) | 避免复杂环境描述 |
| 色彩声明 | 主色+过渡色+辅色 | 三色调色板比双色稳定 |
| 韵律声明 | 1 组矛盾修辞 | “脆弱×高贵””纯净×克制” |
可迁移经验
- 角色 Prompt 的核心不是服装清单,而是视觉结构声明。每次写 Prompt 前先问:这个角色的轮廓语言是什么?把轮廓写在服装前面。
- 色块过渡需要中间色。没有中间色时模型用模糊来弥合,加入银灰/冷灰/香槟色做桥梁,色块边界立刻锐化。
- 把一句话的克制声明放在 Prompt 末尾,效果等同于给模型加了一条”别画太满”的软约束。这不是精准指令,但对输出气质有稳定改善。
FAQ
Q:气场锚定法和传统的角色描述写法的核心区别是什么?
传统的角色描述写法以「角色有什么」为组织轴(服装→武器→发型→身高→表情)。气场锚定法以「角色如何被视觉感知」为组织轴(轮廓→色彩区间→克制声明→在场感)。两者并非互斥,但气场锚定法作为前置框架能为后续细节声明提供稳定的结构基线。
Q:矛盾修辞对模型的影响是稳定的吗?
矛盾修辞的效果依赖模型自身对语义张力的解码能力,不同模型的表现有显著差异。gpt-image-2 和 Seedream 系列对此类修辞的响应最稳定,在部分开源模型中矛盾修辞可能被简化为平均化输出——两种特质各取中间值,产生平庸的脸而非富含张力的脸。
Q:气场锚定法的框架名有后缀规律吗?
截至目前,本站已连续发布多个以「法」字结尾的 Prompt 框架(质感堆栈法、光质梯度法、五区结构法等),后续框架命名已在「法」「术」「编码」三种后缀间轮换。气场锚定法使用「法」后缀是因为其核心逻辑是一套操作步骤序列——先锚轮廓、再锚色彩、再锚克制、最后锚在场感——而非单一技巧。
评论0