
把二次元角色「翻译」进现实,难度不在像,而在「合理」
写实化的跨媒介角色重塑,AI 圈的常规做法是叠限定词:保留原本服装的每一处纹样、复刻原版发型的高度和弧度、把背景也建成游戏场景的复刻版。结果呢?一张精致的 cosplay 合成照,角色和场景像是两个图层拼在一起的,从脸到衣服都透着一股「被摆拍」的僵硬。
问题不在细节写不写,而在写的逻辑对不对。
角色从一个虚构世界走进现实,需要的不只是保留视觉特征,更是让这些特征在一个全新的语境中找到合理的落点。一条凝光空乘重译 Prompt 选择了一条完全不同的路径。
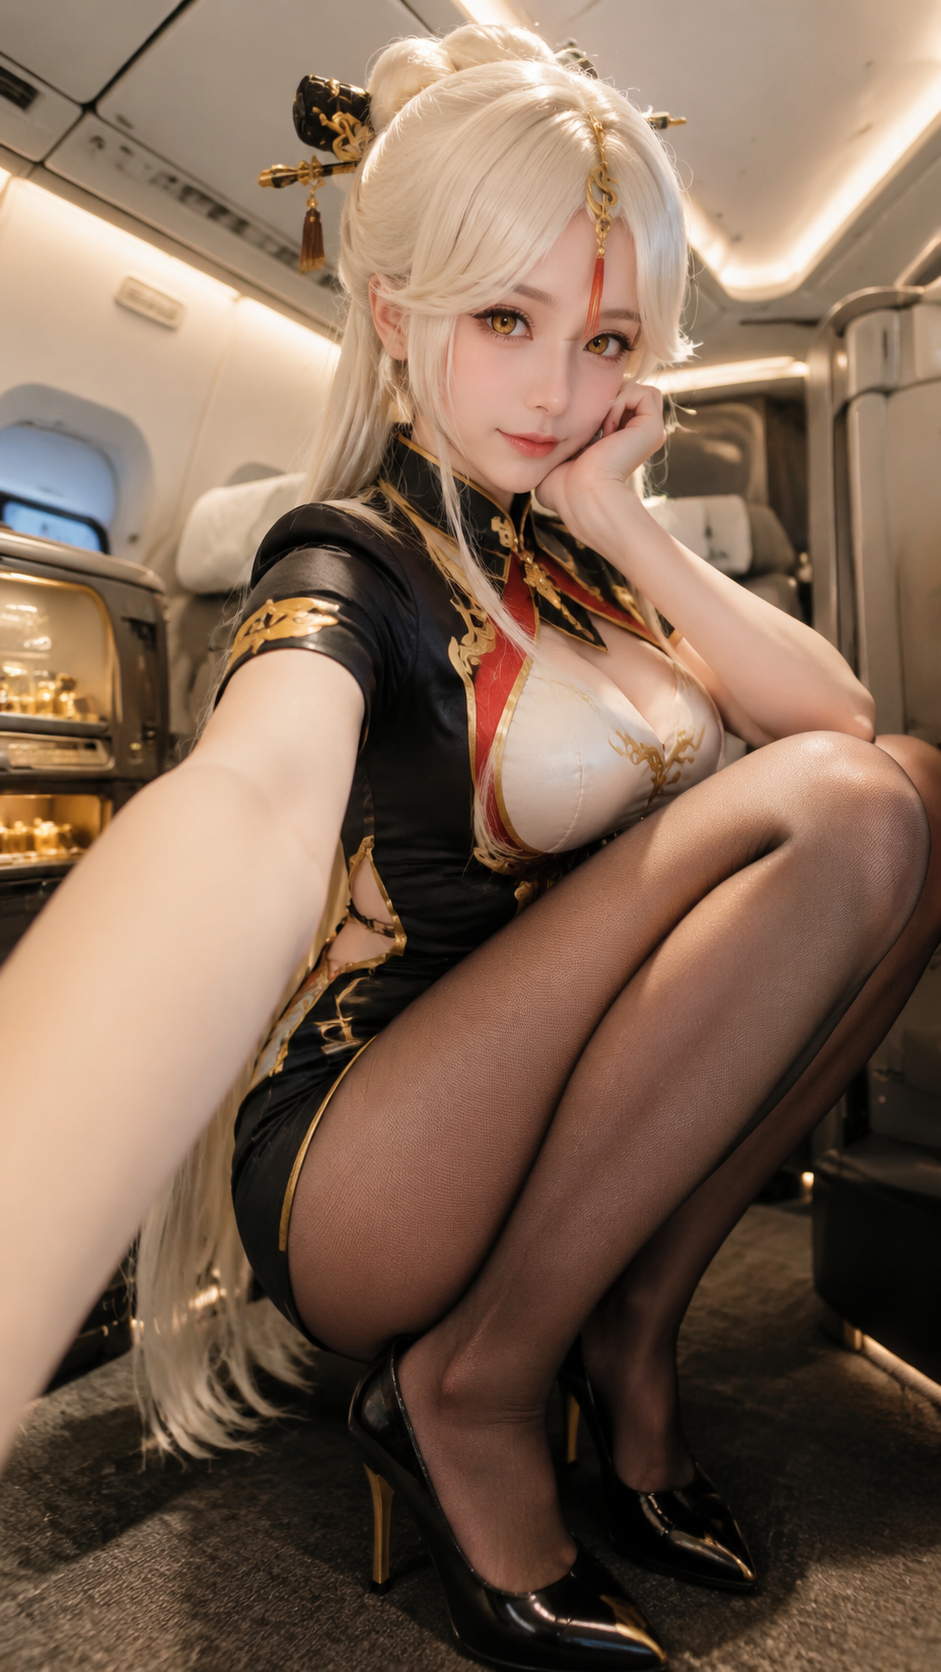
写实电影感手机自拍照片,竖版构图,近距离广角手持自拍视角,整体呈现高级、真实、细腻的职业角色写真质感。
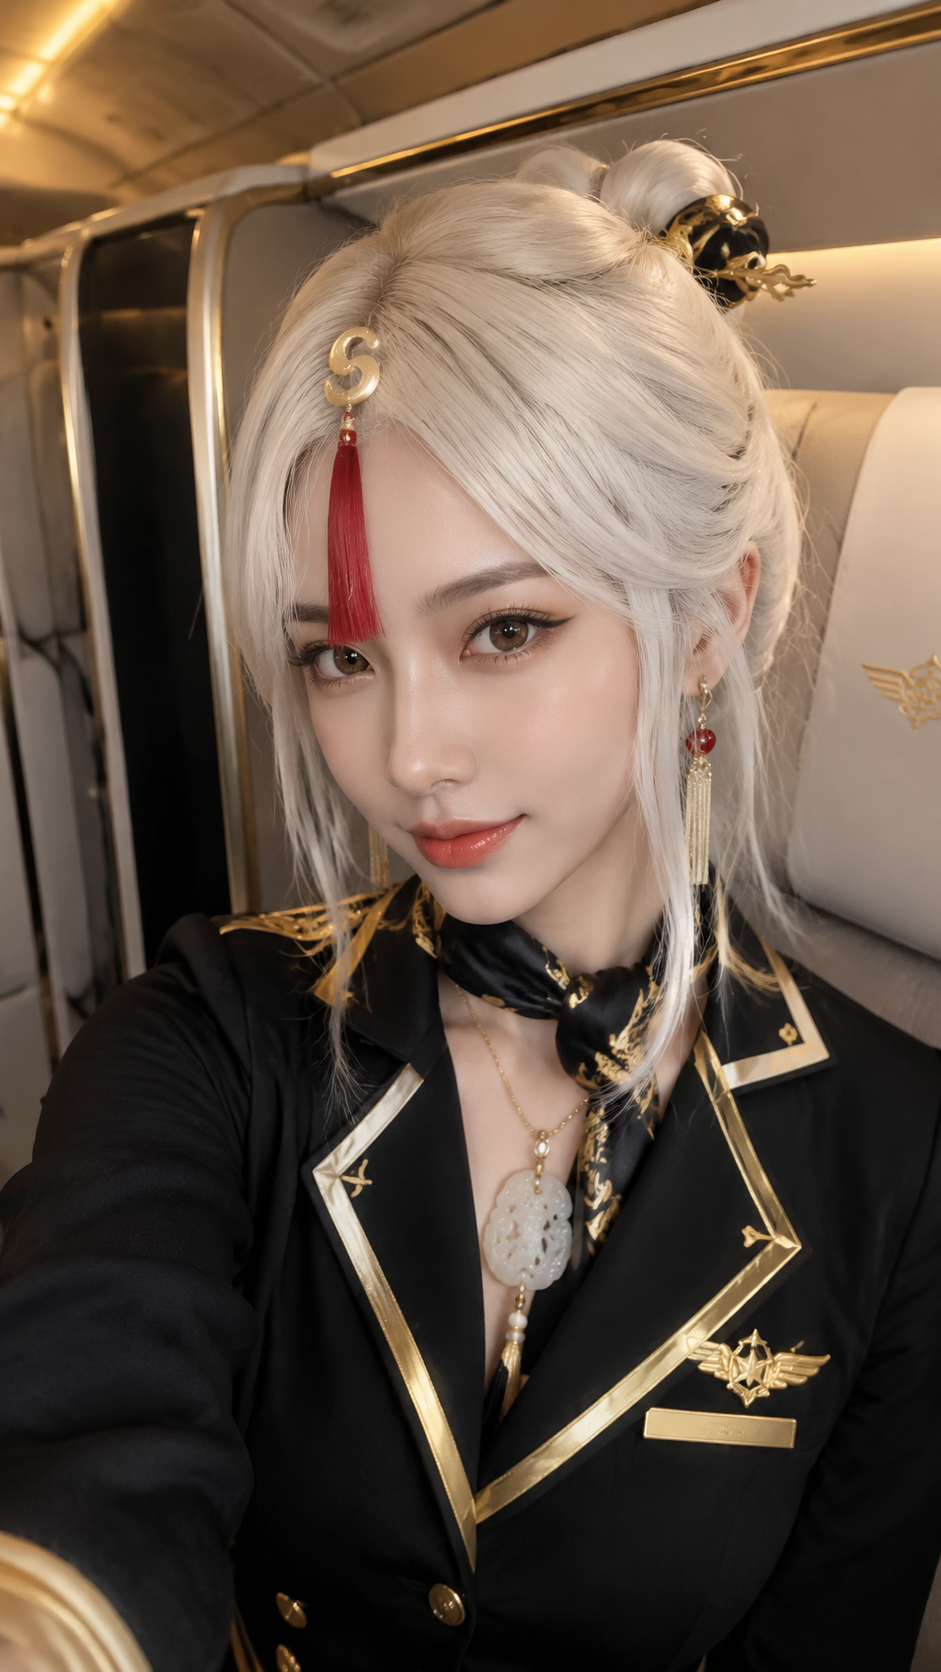
主体为《原神》中的凝光进入现实空乘职业场景后的真人化重释版本。她是一位25岁左右的东亚成年女性,气质冷艳、高贵、从容,带有精致的掌控感和上位者气场。她必须保留凝光最核心的视觉识别点:白金色或银白色长发,发量丰盈顺滑,带凝光式高贵盘束结构与长发垂落;金色或琥珀金色眼睛;精致冷艳的五官;白皙通透的肌肤;黑、金、白、红为核心的细节配色;金色发簪、流苏耳饰、玉石吊坠和中式金纹装饰。
她不是普通空姐,而是凝光被重释为现实世界中的头等舱首席乘务员或高端国际航线空乘形象。妆容精致干净,眼线细致,唇色带自然光泽,表情冷静、自信、从容,带轻微半笑,眼神像始终掌控高端舱服务节奏的精英空乘。
她的身材高挑纤细但曲线非常明显,胸型饱满立体,腰线纤细清晰,臀腿线条圆润流畅,整体体态成熟、优雅、紧致,肩颈、锁骨、腰臀和腿部线条清晰自然,呈现极具视觉冲击力但仍然真实克制的女性曲线美。
人物采取低位蹲姿,双膝并拢,小腿紧贴大腿,身体整体压缩成紧凑而优美的折叠姿态。身体微微侧转,面部以3/4侧脸角度看向镜头。左手轻托下巴,手指自然贴住脸侧,右臂向前下方伸出持机自拍,动作自然放松,但神态保持凝光式的冷艳、自信与掌控感。
镜头使用近距离广角手机自拍构图,由人物右手持机拍摄,镜头下置到接近膝部到小腿高度,从腿部前侧低角度拍向上半身。高跟鞋、脚踝、小腿、大腿构成画面前景,腿部占据画面下半部分并形成自然但强烈的近大远小透视。视觉重点落在修长双腿、凝光式贵气神态、空乘职业造型和夸张但真实的身体曲线上。上半身和脸位于画面中上区域,脸部清晰对焦,背景自然虚化,带真实手机自拍的亲近感。
服装为凝光风格的高级空乘职业重释穿搭:深海军蓝、酒红或黑金配色的修身空姐风迷你连衣裙,带利落翻领、收腰剪裁、精致短袖或修身制服结构,领口、袖口、腰部或裙摆点缀细金边和少量红色细节,整体保留空姐职业的优雅、干练和服务感,同时通过金色发饰、玉石耳饰、黑金白红配色和中式纹样维持凝光辨识度。搭配黑色半透明丝袜与黑色或黑金色尖头细高跟鞋,鞋侧或鞋跟带细金属装饰,进一步强化腿部比例与高端机舱气质。
场景为飞机头等舱区域或高级客舱过道,带头等舱座椅、舷窗、顶柜、柔和地毯、舱内灯光与清晰延伸的机舱纵深,环境整洁、高级、安静。人物真实蹲在机舱过道中,鞋底与地面接触清晰,座椅与过道共同建立空间层次,人物与环境自然融合。
光线采用机舱内柔和暖白顶灯与局部反射光混合照明,脸部、肩颈、手臂和腿部带柔亮高光,金色饰件与玉石细节带细微反光,皮肤保留自然纹理和通透感。整体画面精致、真实,呈现凝光进入现实航空职业世界后的高级写实自拍摄影效果。
这个策略可以称为「身份重译术」——不是把角色搬进现实,而是把角色的身份标记系统翻译成一套现实世界能理解和接受的视觉语言。
身份锚点筛选:不保留的勇气比保留的勇气更难
大多数跨媒介角色 Prompt 犯的第一个错误是「全保留」:游戏角色穿什么,Prompt 里就写什么;游戏角色有什么配色,Prompt 就重复什么。模型收到这样的指令后,不得不在「忠实还原原始设计」和「生成写实图像」之间做权衡,结果通常是两头不靠。
身份重译术的第一步不是决定保留什么,而是决定放弃什么。仔细看这条凝光 Prompt 的视觉标记列表:长发、金瞳、冷白皮、黑金白红配色、金簪、流苏耳饰、玉石吊坠、金纹装饰。这八个标记覆盖了凝光最核心的身份信号——但请注意它放弃了什么:放弃了她游戏中的旗袍领口和内衬设计、放弃了她标志性的棋子权杖、放弃了她宽大袖管的剪裁结构。服装被完全重新设计为空乘制服,只通过配色和纹理保留凝光的影子。
从模型行为角度看,这种「选择性保留」的意义在于压缩冲突空间。当 Prompt 中充斥着矛盾声明——「既要忠于原版服装设计又要写实」「既要保留游戏配饰又要自然」——模型在解码阶段会消耗大量注意力权重去调和这些冲突,结果往往是设计细节变得模糊或者角色整体感崩坏。放弃那些不是最核心的身份标记,就是在解除模型解码阶段的约束冲突。
这个方法的取舍逻辑是一道过滤题:哪些标记一旦移除,角色就不再是这个角色?那些就是必须保留的。其他的,全部可以放掉。
职业语境重释替代场景照搬
大部分角色写实化 Prompt 都会走入一个死胡同:保留角色的原版场景(凝光在群玉阁)然后试图让它看起来像真的。结果是场景的虚幻感直接拉低了整张图的真实度——模型没办法把一个漂浮在空中的豪华建筑渲染得像照片。
身份重译术选择更换整个场景语境。把凝光从群玉阁阁主「翻译」成头等舱首席乘务员。这不是随便选一个职业,而是有意识地在寻找与原角色特质高度匹配的映射关系:凝光的精致与距离感→头等舱服务的礼仪感和专业距离;凝光的掌控者气场→机舱中主导服务节奏的精英空乘定位;凝光的东方美学配色→黑金白的制服配色方案有天然的职业适配度。
更重要的是,Prompt 花了大量笔墨在职业角色的行为细节上——「眼神像始终掌控高端舱服务节奏」「表情冷静、自信、从容,带轻微半笑」。这些行为声明做了一件关键的事:它们告诉了模型这个角色「如何存在」而非「长什么样」。角色在场感的核心来源不是服装纹理的长度声明,而是行为细节引发的移情联想。模型在解码行为声明时,会激活动作解码相关的注意力通路,这直接影响了角色姿态和表情的自然度。
自拍视角作为空间叙事装置
这条 Prompt 在构图上做了一个大胆的选择:用手机自拍视角替代了标准的第三人人像视角。这个选择的聪明之处在于它同时解决了三个问题。
视角的真实性。手机自拍视角是观众在日常生活中最熟悉的拍摄方式之一,模型对这种构图方式有大量的训练数据。低角度自拍意味着前景的自然构件——腿部、手部——会被模型自动解码为「镜头前遮挡物」,而非「画面主体缺失」。结果是透视变形看起来自然,而不是构图失误。
前景叙事功能。低角度自拍让腿部成为画面下半部分的核心构成,这恰好为 Prompt 中大量腿部描述提供了一个天然的容纳空间——它们不是因为「需要展示」而被描述,而是因为「处于自拍视角中」而被描述。这种因果逻辑让模型在解码时不会觉得「为什么这里要出现腿的描述」,避免了特征堆砌感。
角色在场感的加固。自拍视角天然带有「角色对自己存在的意识」,这和凝光这个角色「自知的掌控感」是高度一致的。角色不是被拍摄,而是主动拍摄自己——这个微妙的主体性差异,在模型解码层面体现为更自然的表情控制和姿态放松度。
蹲姿的三重功能声明
低位蹲姿在 Prompt 中不是随便选的一个姿态,它同时承担了三重叙事功能。
结构功能。蹲姿在画面中制造了从腿部到面部的一整个垂直视觉流——脚尖→膝盖→腰线→面部,形成一个完整的Z形视线引导路径。相比站姿(只有一个竖直柱),蹲姿的折线结构让视觉有了更多的停留点和流动方向。
功能凭证。蹲姿和自拍视角之间的因果关联是天然成立的——一个人蹲下用广角自拍,这个动作在日常生活中有清晰的行为逻辑。模型不需要额外解释为什么会有这个姿态,「蹲下自拍」本身就是一套完整的行为脚本。
角色功能。对于凝光这个角色来说,蹲姿的折线体态与其惯常的站姿和坐姿形成张力——一个习惯于居高临下、运筹帷幄的角色,被放在一个压缩的姿态中。这种张力在模型解码层面产生了一个有趣的效应:由于姿态的收缩和面部神态的舒展形成了对比,角色表情获得了更大的信息密度——既有姿态上的收敛,又有神态上的从容,角色的层次感由此产生。
局部光声明替代全局色板声明
这条 Prompt 在光线描述上采用了一种不同寻常的策略:不写「暖色调」或「冷色调」这类全局声明,而是写「柔亮高光」「细微反光」「自然纹理和通透感」这类局部光影效果声明。
这不是随便替换个词的差别。全局色调声明(暖色/冷色/暗调)作用的是模型的整体色彩解码分布——它会让模型倾向于把整张图的色温向一个方向偏移。局部光声明作用的是模型的局部材质解码——它会激活模型在特定区域生成高光、反射和纹理过渡的能力。
对于写实类角色图来说,影响真实感的决定性因素不是整体色调的准确性,而是局部光影是否能模拟真实材质的光学行为。金色发簪的反光、玉石吊坠的半透明、丝袜对光线的漫反射——这些局部光影声明比一句「写实风格」对整个画面的真实性贡献大得多。
身份重译术的可迁移维度
这个框架的核心控制逻辑——筛选身份锚点 → 映射职业语境 → 选择叙事视角 → 叠加功能姿态 → 局部光声明——不限于角色还原场景。对产品可视化场景,可以通过语境映射和局部光声明解决产品与场景的融合问题。对电影氛围设计,自拍视角和功能姿态的组合可用于模拟主观视角叙事。对个人肖像生成,选择性保留的思维同样适用于「优化而非复刻」的策略。
技术参数表
| 参数 | 推荐值 | 说明 |
|---|---|---|
| 模型 | gpt-image-2 | 长 Prompt 解码稳定,局部光影控制精准 |
| 尺寸 | 1536×1024(特色图) | 3:2 横版 |
| 尺寸 | 1440×2560(正文图) | 9:16 竖版,自拍构图适配 |
| 身份锚点密度 | 5-8 个核心标记 | 超过会稀释角色识别度 |
| 语境映射匹配度 | 原角色特质 × 新语境属性 | 映射关系越自然,模型冲突越少 |
| 视角决定景深分配 | 自拍视角优先前景 | 利用模型训练数据中的自拍分布特征 |
| 功能姿态 | 1 个姿态承担 ≥2 个功能 | 不写「只是为了好看」的姿态 |
可迁移经验
- 跨媒介角色 Prompt 的第一步不是决定写什么,而是决定不写什么。列出角色的所有身份标记,去掉那些「去掉也不影响识别」的,只保留不可替代的。删得越狠,模型冲突越少。
- 给角色换职业不是随便换一个。找角色性格特质和新职业日常行为之间的映射关系——冷艳→头等舱礼宾、掌控→服务流程主导者、距离感→专业礼仪边界。映射越精准,角色在场感越强。
- 自拍视角从根本上改变了角色的主体性。如果有人物构图的空间,且场景允许手持设备的逻辑,自拍视角比第三人称视角带来更自然的姿态和更少的行为伪影。
FAQ
Q:身份重译术和传统的 cosplay 类 Prompt 的核心区别是什么?
传统 cosplay Prompt 以「复制视觉设计」为核心目标——服装、武器、场景尽量还原。身份重译术以「翻译角色身份」为核心目标——保留身份锚点但重写所有其他上下文。前者做的是「像」,后者做的是「是」。
Q:身份锚点筛选有没有量化标准?
一个粗略的参考标准:在人物辨识度实验中,如果把某个特征从角色身上移除,超过 70% 的玩家无法准确识别角色身份——那它就是核心锚点。对于凝光来说,银白长发、金瞳、金红黑配色和发簪饰品构成了不可移除的四件套。其他如服装纹理、配饰数量都是可替换项。
Q:自拍视角的局限性在哪里?
自拍视角在全身和七分身构图中表现最好,但在大头特写和强调环境氛围的场景中会限制画面表达。如果一张图的核心视觉冲击来自场景与环境,而非人物与视角的真实感,那么第三人称视角仍然是更优选择。
评论0